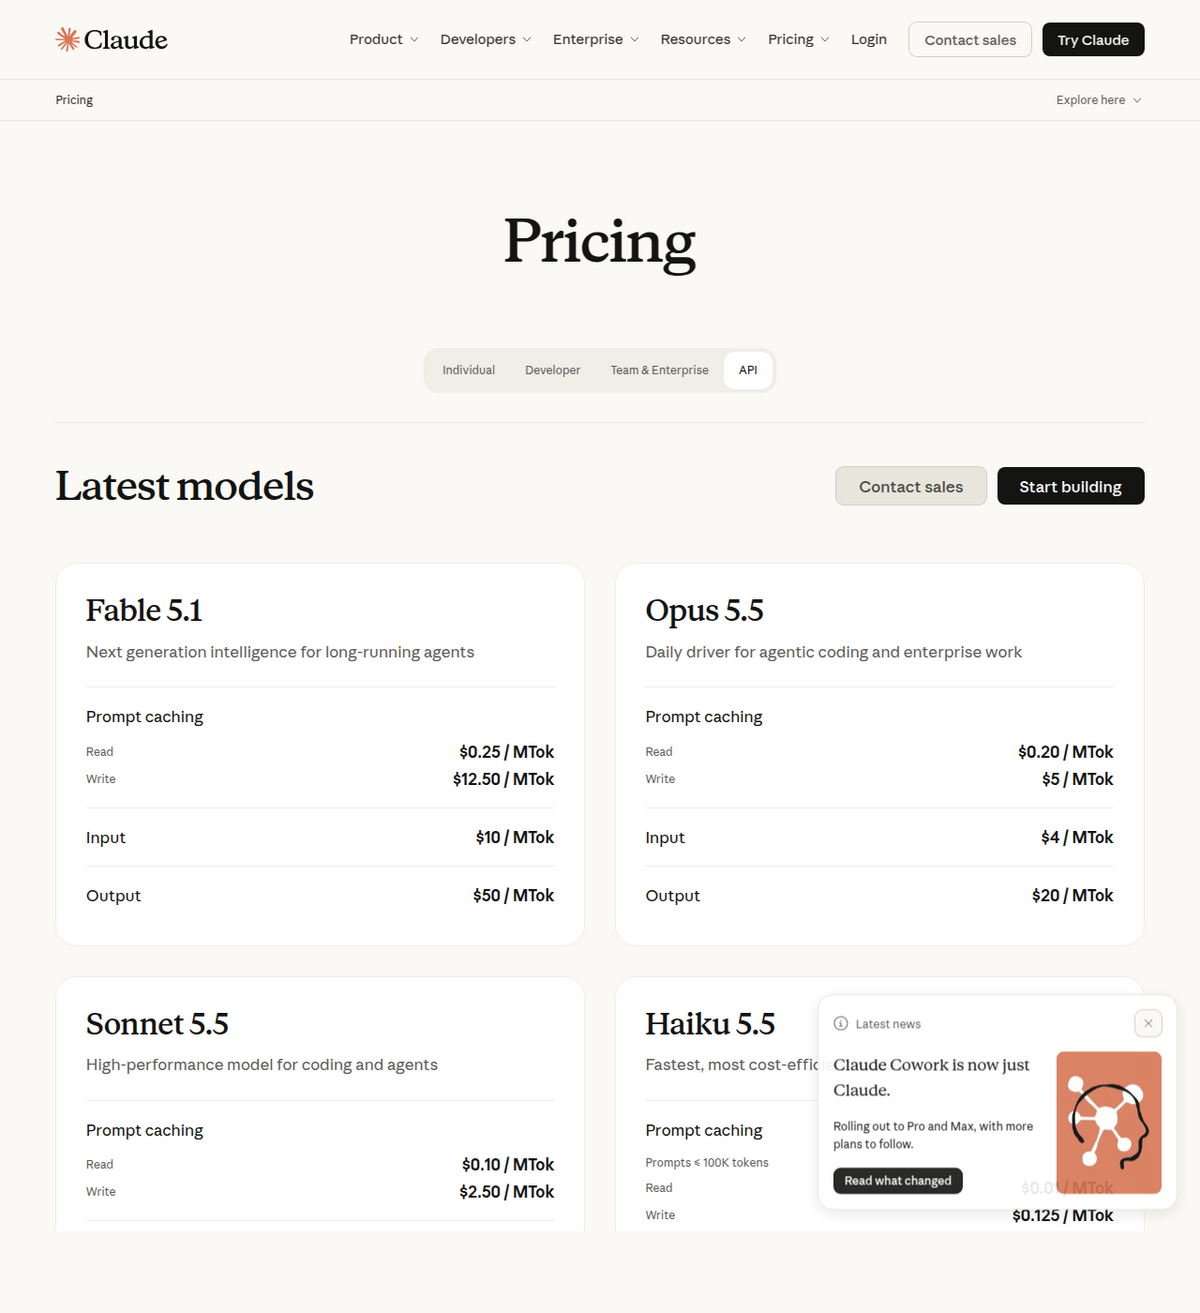
Claude Sonnet 5.5 startete am 28. September 2026, als zweites Release in Anthropics „5.5"-Auffrischung, sechs Tage nach Opus 5.5 (22. September). Der Preis blieb gegenüber Sonnet 5 unverändert: 2 $ pro Million Input-Token, 10 $ pro Million Output-Token. Der eine Preis, der sich tatsächlich änderte, lässt sich leicht übersehen: Cached-Prompt-Lesevorgänge fielen auf 0,10 $ pro Million Token, die Hälfte von Sonnet 5s altem 0,20-$-Satz. Die meisten Drittanbieter-Preistracker, die wir geprüft haben, listen weiterhin 0,20 $ als aktuellen Wert.
Bei Wissensarbeit- und Computernutzungs-Benchmarks liegt es nahezu gleichauf mit Opus 5.5, für den halben Preis. Sonnet 5.5 erzielt 1844 Punkte bei GDPval-AA v2.1 gegenüber Opus' 1846, und 80,1% bei OSWorld 2.1 gegenüber Opus' 81,8%, Abstände von ein bis zwei Punkten trotz des doppelten Preisunterschieds.
Anthropics eigene Herstellerangabe und der Nachtest eines unabhängigen Labors widersprechen sich. Anthropic gibt 70,6% bei Terminal-Bench 4.0 an; Artificial Analysis' unabhängiger Nachtest desselben Benchmarks ergab 64%, immer noch vor Opus 5.5s 60% auf AAs eigenem Testaufbau, aber eine echte Lücke zwischen der Marketing-Zahl und reproduzierten Ergebnissen, die man kennen sollte, bevor man darauf plant.
Die Behauptung „bis zu 30% günstiger" gilt nicht bei jeder Einstellung. Bei maximalem Reasoning-Aufwand erzeugt Sonnet 5.5 im Schnitt rund 193.000 Output-Token pro Aufgabe, der höchste Wert, den Artificial Analysis je für ein Modell gemessen hat, was die Kosten pro Aufgabe auf etwa 7,60 $ treibt, höher als bei Sonnet 5 und, nach einer Messung, höher als bei Opus 5.5, das dieselbe Qualitätsschwelle mit weniger, teureren Token erreicht.
Was erschien, und in welcher Reihenfolge
Unser eigener Opus-5.5-Ratgeber nannte die umgekehrte Reihenfolge, bis wir sie bei der Recherche zu diesem Artikel korrigierten. Anthropics eigene Modell-Dokumentation listet Opus 5.5s Release mit 22. September 2026 und Sonnet 5.5s mit 28. September 2026, sechs Tage später, nicht früher. Die Reihenfolge ist wichtig dafür, wie man den Vergleich liest: Sonnet 5.5 ist der Nachfolge-Act, der Opus 5.5s Benchmark-Werte zu übertreffen hatte, nicht das Vorprogramm.
Die API-Modell-ID ist claude-sonnet-5-5, verfügbar über die Claude API, Amazon Bedrock, Google Cloud Vertex AI und Microsoft Foundry. Das Kontextfenster bleibt bei 1 Million Token, mit einer Output-Grenze von 128K Token bei Standard-Anfragen, erweiterbar auf 300K Token über die Batch API hinter einem output-300k-2026-03-24-Beta-Header. Der Wissensstand liegt bei Juni 2026, sowohl für das Training als auch für verlässliches Abrufen. Eine Verhaltensvorgabe änderte sich gegenüber Sonnet 5: Sonnet 5.5 denkt standardmäßig mit hohem Aufwand (Opus 5.5 setzt standardmäßig auf mittel), und seine niedrigste manuelle Denk-Einstellung ist jetzt between_tools statt der alten Option disabled, eine Breaking Change, falls die eigene Integration Thinking explizit ausgeschaltet hatte.
Der Preis-Haken: Cache-Lesevorgänge wurden günstiger, und die meisten Tracker haben es verpasst
Input- und Output-Preise wurden unverändert von Sonnet 5 übernommen: 2 $ pro Million Input-Token, 10 $ Output. Beim Prompt-Caching hat sich tatsächlich etwas bewegt. Anthropics Dokumentation erklärt, Sonnet 5.5 behalte dieselben Preise wie Sonnet 5, „außer bei Prompt-Cache-Lesevorgängen, die 0,10 USD pro Million Token kosten, die Hälfte des Claude-Sonnet-5-Satzes". Cache-Schreibvorgänge bleiben bei 2,50 $/Million für einen 5-Minuten-Cache und 4 $/Million für einen 1-Stunden-Cache. Die Batch API gewährt weiterhin einen Rabatt von 50% auf Input und Output, effektiv 1 $/5 $ pro Million Token für asynchrone Workloads.
Wir haben mehrere nach dem Sonnet-5.5-Launch veröffentlichte Preis-Übersichten geprüft, und mehr als eine, darunter eesel.ais Preisleitfaden, listet Cache-Lesevorgänge weiterhin mit 0,20 $, der alten Sonnet-5-Zahl, statt der korrigierten 0,10 $. Bei einer Budgetplanung für einen Workload mit hoher Cache-Trefferrate summiert sich die Lücke: Ein Workload, der größtenteils aus dem Cache liest, kostet rund die Hälfte dessen, was eine veraltete Tabelle vermuten ließe. Jede Preisangabe direkt gegen Anthropics eigene Dokumentation prüfen statt gegen eine Sekundärtabelle, einschließlich dieser hier, bevor man ein Budget darauf festlegt.
Benchmarks: ein knapper Gleichstand mit Opus, mit einer Herstelleraussage-gegen-unabhängig-Lücke
Benchmark                    Sonnet 5.5   Opus 5.5   Sonnet 5
----------------------------------------------------------------
GDPval-AA v2.1 (knowledge work)    1844         1846        1449
OSWorld 2.1 (partial credit)       80.1%        81.8%       57.0%
OSWorld 2.1 (strict pass)          43.5%        48.7%       25.6%
Terminal-Bench 4.0 (Anthropic)     70.6%        66.4%       10.3%
Terminal-Bench 4.0 (AA re-test)      64%          60%          -
FrontierCode 1.1 (xhigh effort)    52.1%        54.4%       42.4%
CursorBench 4.0                    55.5%        57.8%       34.1%
Humanity's Last Exam (w/ tools)    64.5%        67.7%       54.9%

AA = Artificial Analysis, an independent benchmark lab.
Terminal-Bench shows the largest vendor-vs-independent gap of
any figure checked for this article.
Bei GDPval-AA, einem Wissensarbeit-Benchmark, und OSWorld, einem Test zur Bedienung eines echten Computers über eine grafische Oberfläche, liegt Sonnet 5.5 innerhalb von ein bis zwei Punkten von Opus 5.5, trotz halber Kosten. Das ist die Schlagzeile, mit der die meisten Berichte vorangehen, und sie ist korrekt. Was die meisten Berichte auslassen, ist die OSWorld-Aufteilung: Der Wert von 80,1% ist Partial Credit, der Fortschritt auf eine Aufgabe hin honoriert, selbst wenn sie nicht vollständig erledigt wird. Die strikte Erfolgsquote, nur vollständige Aufgabenerledigung, liegt bei 43,5% für Sonnet 5.5 gegenüber 48,7% für Opus 5.5, eine Lücke, die sich von 1,7 Punkten bei Partial Credit auf 5,2 Punkte beim strikten Bestehen ausweitet, eine deutlich andere Zahl, an der man sich orientieren sollte, wenn der eigene Anwendungsfall eine fertige statt eine größtenteils fertige Aufgabe braucht.
Die Terminal-Bench-Lücke ist es wert, eigens benannt zu werden. Anthropics Launch-Material gibt 70,6% für Sonnet 5.5 an. Artificial Analysis, ein unabhängiges Labor, das Benchmarks auf seinem eigenen Testaufbau nachstellt statt Herstellerangaben unbesehen zu übernehmen, maß 64%, ein Rückgang von sechs Punkten gegenüber der Herstellerangabe, wenn auch weiterhin vor Opus 5.5s 60% auf demselben Testaufbau. Keine der beiden Zahlen ist exakt falsch; sie spiegeln unterschiedliche Testbedingungen wider. Aber eine Sechs-Punkte-Lücke zwischen dem, was ein Unternehmen angibt, und dem, was eine unabhängige Partei reproduziert, ist die Art Detail, die in jeden ernstzunehmenden Vergleich gehört, und sie fehlte weitgehend auf den Konkurrenzseiten, die wir geprüft haben.
Ein Hacker-News-Thread zum Launch (884 Punkte, 613 Kommentare) brachte eine verwandte Komplikation ins Spiel: Ein Teil von Sonnet 5.5s Vorsprung gegenüber Opus 5.5 bei einigen agentischen Benchmarks könnte Opus' Safety-Routing-Verhalten widerspiegeln statt einer reinen Fähigkeitslücke. Ein Kommentator führte an, Opus 5.5 falle in rund 10% der Versuche aufgrund ausgelöster Schutzmechanismen auf ein schwächeres Modell zurück, deutlich über Sonnets Rückfallquote bei denselben Tests. Das ist eine Beobachtung aus der Community, keine von Anthropic bestätigte Zahl, aber eine plausible Erklärung dafür, warum ein günstigeres Modell bei bestimmten Tests ein teureres immer wieder nahezu einholt oder knapp überholt.
Die eigentliche Kostengeschichte: Token-Geschwätzigkeit bei maximalem Aufwand
Anthropic vermarktet Sonnet 5.5 damit, Aufgaben zu bis zu 30% niedrigeren Kosten als Sonnet 5 zu erledigen. Diese Behauptung ist bei Anthropics gewähltem Aufgabenmix und Aufwandsniveau real, gilt aber nicht universell, und diese Lücke ist die nützlichste einzelne Tatsache in diesem Artikel für jeden, der die Rechnung tatsächlich bezahlt. Artificial Analysis maß, dass Sonnet 5.5 bei maximalem Reasoning-Aufwand im Schnitt rund 193.000 Output-Token pro Aufgabe erzeugt, der höchste Wert, den AA für irgendein von ihr verfolgtes Modell aufgezeichnet hat, etwa 60% mehr als Opus 5.5 oder Sonnet 5 bei derselben Maximaleinstellung, und rund siebenmal so geschwätzig wie GPT-6 Astra bei vergleichbaren Aufgaben.
Diese Geschwätzigkeit zeigt sich direkt in den Kosten pro Aufgabe: AA maß Sonnet 5.5 bei maximalem Aufwand mit rund 7,60 $ pro Aufgabe, etwa 50% höher als Sonnet 5s Kosten bei derselben Einstellung. In einem AA-Vergleich erreichte Opus 5.5 Sonnet 5.5s Spitzen-Qualitätswert für etwa 3,46 $ pro Aufgabe, und brauchte dafür weniger, teurere Token statt vieler günstigerer, insgesamt günstiger als Sonnet 5.5s eigener Max-Aufwand-Durchlauf. Die praktische Lehre: Sonnet 5.5s Preisvorteil ist bei seiner Standard-Einstellung mit hohem Aufwand für gut umrissene Aufgaben real und kann verschwinden oder sich umkehren, wenn man es auf maximalen Aufwand bei etwas wirklich Schwerem treibt, wo Opus 5.5s weniger, teurere Token die Aufgabe manchmal günstiger abschließen.
Sonnet 5.5 gegen Opus 5.5: wozu Anthropic selbst rät
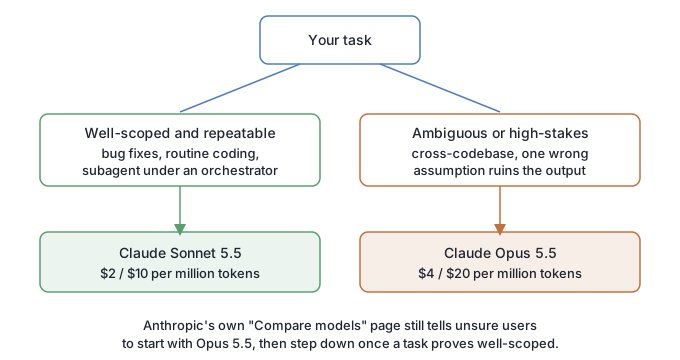
Anthropic positioniert Sonnet 5.5 nicht als Ersatz für Opus 5.5. Die eigene Ankündigung nennt Sonnet 5.5 „eine schnellere, günstigere Ergänzung zu Claude Opus 5.5" und reserviert Opus für „komplexe Arbeit, die sorgfältiges Urteilsvermögen erfordert". Die Modell-Vergleichstabelle in der Dokumentation ist noch unverblümter: Sie rät unentschlossenen Nutzern, bei den meisten Workloads mit Opus 5.5 zu beginnen, und behandelt Sonnet als das Modell, auf das man wechselt, sobald man bereits weiß, dass eine Aufgabe gut umrissen ist, nicht als Standardwahl.
Hinter dieser Empfehlung steht ein echter Genauigkeits-Tradeoff, den Benchmark-Tabellen nicht direkt zeigen. Bei Artificial Analysis' Omniscience-Test, einem Maß für faktische Genauigkeit, erzielt Opus 5.5 66% gegenüber Sonnet 5.5s 54%, Opus weiß schlicht mehr Fakten korrekt. Aber bei der Halluzinationsrate liegt Sonnet 5.5 tatsächlich niedriger (besser) bei 47% gegenüber Opus' 59%: Wenn Sonnet 5.5 etwas nicht weiß, sagt es das eher, statt zu raten, auch wenn es insgesamt mit weniger Wissen arbeitet. Für Recherche-Synthese speziell kann eine niedrigere Halluzinationsrate bei dem, was es versucht, mehr zählen als eine höhere Rohwissens-Obergrenze, abhängig davon, ob man lieber eine Lücke erkennt oder eine selbstbewusst formulierte falsche Antwort.
Die Beschwerde, die die Entwicklerdiskussion dominiert: Schutzmechanismen blockieren gewöhnliche Arbeit
Das lauteste wiederkehrende Thema in jenem Hacker-News-Thread war nicht Preis oder Benchmarks, sondern Anthropics Cyber-Schutzsystem, das legitime Arbeit als riskant einstuft. Entwickler berichteten, bei Aufgaben wie ESP32-Bluetooth-Firmware, alter C-Code-Durchsicht, Write-Ahead-Log-Implementierungen und autorisierter Bug-Bounty-Recherche blockiert oder in einen eingeschränkten Modus geleitet zu werden. Die Zusammenfassung eines Kommentators, „Ich will kein Nanny-Tool", wurde durch den Thread hinweg wiederholt aufgegriffen, zusammen mit Beschwerden, dass das zugrunde liegende „Cyber Verification Program" Falsch-Positive ohne klaren Widerspruchsweg produziert.
Ein zweiter Beschwerde-Cluster drehte sich um Nutzungslimits statt Safety-Routing: Mehrere Nutzer berichteten, ihre Max-Plan-Kontingente deutlich vor der Erneuerung der Abrechnungsperiode ausgeschöpft zu haben, einer nannte einen Opus-5.5-20x-Plan, der in vier von sieben Tagen aufgebraucht war, und ein separater Bericht schilderte ein Team, das ein monatliches Token-Budget von 10.000 $ in weniger als einem Tag intensiver agentischer Nutzung erreichte. Keine der beiden Beschwerden ist spezifisch für Sonnet 5.5s Fähigkeiten, aber beide beeinflussen die praktischen Kosten, es in einem agentischen Workflow einzusetzen, und keine taucht in einem Benchmark-Diagramm auf.
Ein unabhängig durchgeführter Vergleich gibt ein konkreteres Gefühl für die Zuverlässigkeit in der Praxis. Die Code-Review-Plattform CodeRabbit testete Sonnet 5.5 gegen Sonnet 5 an 13 Pull Requests mit bekannten, bereits katalogisierten Fehlern: Sonnet 5.5 fand 6 von 13 gegenüber Sonnet 5s 4 von 13, bei rund 60% niedrigeren Kosten pro Review und etwa der halben Latenz (ein Mittelwert von 5 Minuten 27 Sekunden gegenüber 9 Minuten 55 Sekunden). Opus 5.5 fand weiterhin mehr, 8 bis 10 derselben 13 Fehler, abhängig vom Durchlauf. Das entspricht dem Muster, das Anthropics eigene Positionierung beschreibt: Sonnet 5.5 ist zum selben Preis ein echtes Upgrade gegenüber Sonnet 5, und Opus 5.5 findet weiterhin mehr bei den Fällen, die am meisten zählen.
Sonnet 5.5 gegen das Feld: GPT-6 Sol und das Pareto-Problem
OpenAIs GPT-6 Sol ist identisch zu Sonnet 5.5 bei 2 $/10 $ pro Million Token bepreist, was die beiden zu einem direkten Kostenvergleich macht. Sonnet 5.5 führt deutlich bei GDPval-AA (1844 vs. 1487) und bei AA-Briefcase (1811 vs. 1483) und liegt bei FrontierCode (52,1% vs. 49,3%) knapp vorn. Aber Artificial Analysis merkt an, dass Sonnet 5.5 bei gleichem Preis abseits der Intelligenz-pro-Output-Token-Grenze liegt, wegen desselben oben beschriebenen Geschwätzigkeitsproblems: GPT-6 Sol liefert mehr gemessene Fähigkeit pro Output-Token bei einem vergleichbaren Preispunkt, selbst dort, wo Sonnet 5.5 bei rohen Benchmark-Werten gewinnt. Welches der beiden Modelle in der Produktion tatsächlich weniger kostet, hängt stark davon ab, wie geschwätzig der eigene spezifische Workload ein Modell werden lässt, nicht nur von der Schlagzeilen-Benchmark-Tabelle.
Wer Sonnet 5.5 tatsächlich nutzen sollte
- Nutze Sonnet 5.5, wenn die eigene Arbeitslast gut umrissen und wiederholbar ist: Routine-Coding, Bugfixes mit klarem Reproduktionsfall, oder ein Subagent, der unter einem Opus-Level-Orchestrator läuft. Hier zahlen sich die nahezu an Opus heranreichenden Benchmark-Werte zum halben Preis tatsächlich aus.
- Nutze Sonnet 5.5, wenn man bereits auf Sonnet 5 war und nichts geändert hat. Das Upgrade ist über den
sonnet-Modell-Alias effektiv kostenlos, und unabhängige Tests (CodeRabbits PR-Review-Vergleich, ein separater praktischer Editing-Agent-Test) zeigen einen echten Qualitätssprung zum selben Preis. - Eskaliere zu Opus 5.5, wenn die Aufgabe mehrdeutig ist, eine unbekannte Codebasis umfasst, oder eine einzelne falsche Annahme teuer wäre. Opus' Vorsprung gegenüber Sonnet wächst genau bei diesen schwereren, weniger umrissenen Fällen.
- Verlasse dich nicht auf „bis zu 30% günstiger" bei maximalem Aufwand. Wenn man Sonnet 5.5 bei wirklich schweren Problemen auf seine höchste Reasoning-Einstellung treibt, den tatsächlichen Token-Verbrauch prüfen. Unabhängige Messung ergab, dass es mehr kosten kann als Sonnet 5, und manchmal mehr als Opus 5.5, das dasselbe Ergebnis erreicht.
- Budgetiere Cache-intensive Workloads mit 0,10 $/Million für Lesevorgänge, nicht mit der 0,20-$-Zahl, die mehrere Preistracker weiterhin veröffentlichen.
Häufig gestellte Fragen
Wann kam Claude Sonnet 5.5 auf den Markt, und vor oder nach Opus 5.5?
Am 28. September 2026, sechs Tage nach Claude Opus 5.5 (22. September 2026), nicht davor. Eine frühere Version unseres eigenen Opus-5.5-Ratgebers hatte die Reihenfolge vertauscht; wir haben sie nach Abgleich mit Anthropics eigener Dokumentation korrigiert.
Wie viel kostet Claude Sonnet 5.5?
2 $ pro Million Input-Token und 10 $ pro Million Output-Token, unverändert gegenüber Sonnet 5. Cached-Prompt-Lesevorgänge kosten 0,10 $ pro Million Token, die Hälfte von Sonnet 5s altem 0,20-$-Satz, eine Änderung, die mehrere Drittanbieter-Preistracker noch nicht aktualisiert haben. Die Batch API gewährt zusätzlich 50% Rabatt auf die Standardpreise.
Ist Claude Sonnet 5.5 so gut wie Opus 5.5?
Bei GDPval-AA (Wissensarbeit) und OSWorld (Computernutzung) erzielt Sonnet 5.5 Werte innerhalb von ein bis zwei Punkten von Opus 5.5, trotz halber Kosten. Opus 5.5 zieht bei schwereren, weniger umrissenen Benchmarks und bei faktischer Genauigkeit vor (66% vs. 54% bei AA-Omniscience), während Sonnet 5.5 tatsächlich weniger halluziniert, wenn es eine Antwort nicht kennt (47% vs. 59%).
Ist Claude Sonnet 5.5 wirklich bis zu 30% günstiger als Sonnet 5?
Bei Anthropics gewähltem Aufgabenmix und Standard-Aufwandsniveau ja. Bei maximalem Reasoning-Aufwand ergab unabhängiges Testen, dass Sonnet 5.5 weit mehr Output-Token pro Aufgabe erzeugt als Sonnet 5, was die Kosten pro Aufgabe bei dieser Einstellung um rund 50% höher treibt als bei Sonnet 5, und manchmal höher als bei Opus 5.5, das dieselbe Qualität mit weniger Token erreicht.
Warum beschweren sich Leute über Claudes Cyber-Schutzmechanismen bei Sonnet und Opus 5.5?
Entwickler haben berichtet, dass legitime Arbeit, Firmware-Code, alte C-Durchsicht, autorisierte Sicherheitsforschung, von Anthropics Cyber Verification Program markiert oder eingeschränkt wurde. Die Beschwerde betrifft keine konkrete falsche Antwort; sie betrifft Falsch-Positive, die gewöhnliche Entwicklungsarbeit unterbrechen, ohne einen klaren Weg zur Klärung.