Mistral Large 4 ist am 6. Oktober 2026 in der Public Preview gestartet, ein Mixture-of-Experts-Modell mit 52 Milliarden aktiven Parametern, eine Zahl, auf die sich Mistrals eigener Blog und die technische Dokumentation inzwischen einigen. Bei der Gesamtparameterzahl sind sich Mistrals eigene Materialien weiterhin uneinig: 1 Billion laut Blog, 1,05 Billionen laut technischer Dokumentation, und ein vageres „>1 Billion" in der EU-AI-Act-Rechtsunterlage. VentureBeats Berichterstattung am Launch-Tag nannte separat 49 Milliarden aktive Parameter, eine Zahl, die in keinem aktuellen Mistral-eigenen Material auftaucht.
Beim Kontextfenster gibt es eine ähnliche Lücke. Mistral nennt 1 Million Token. Die unabhängigen Tracker Artificial Analysis und Vals.ai messen in der Praxis beide eher 512.000-524.000 Token, und selbst Artificial Analysis' eigene Spezifikations-Box und FAQ widersprechen sich (524k gegenüber 520k).
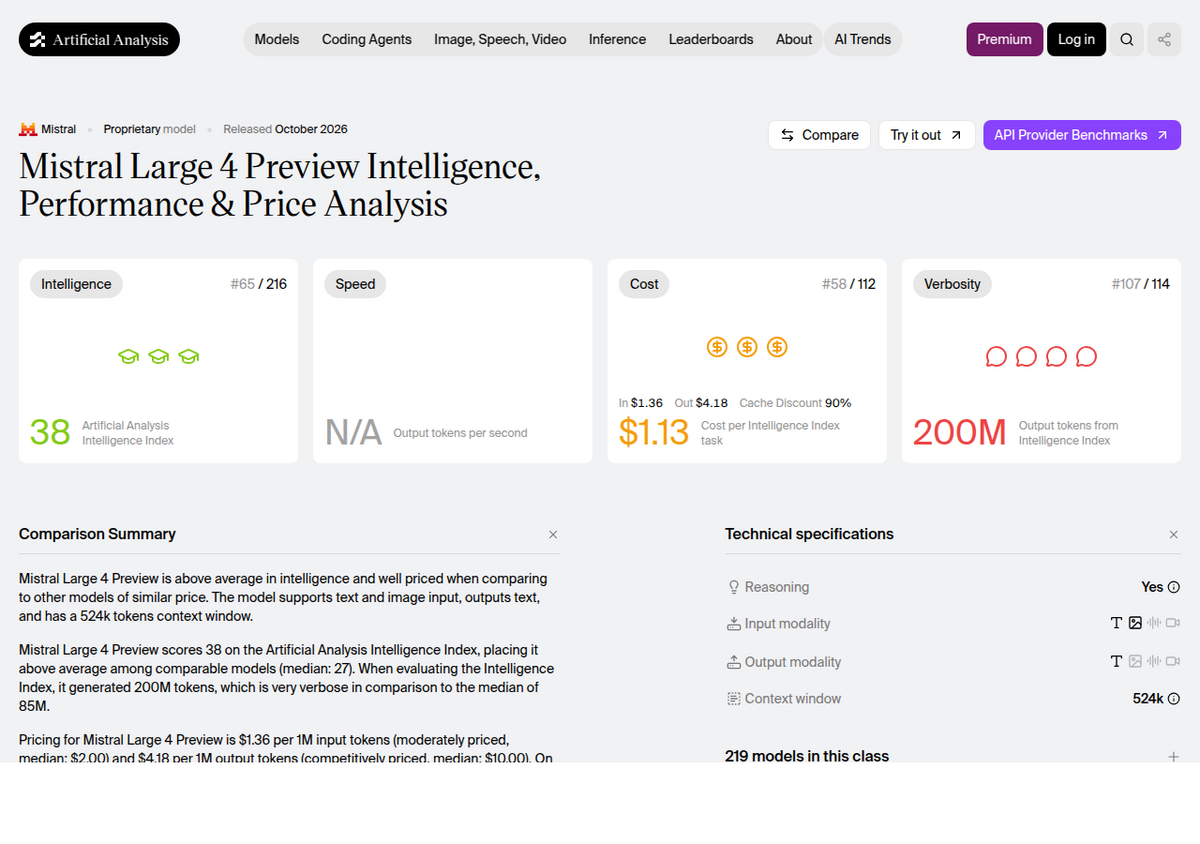
Unabhängig gemessen schneidet es solide ab, aber nicht an der Spitze. Artificial Analysis setzt es bei 38 auf seinem Intelligence Index an, Rang 65 von 216 erfassten Modellen, über dem Median der Kategorie, aber deutlich hinter Claude Opus 5.5 (58) und mehreren chinesischen Open-Modellen.
Aktuell gibt es nur die API, keine kostenlose Stufe. Offene Gewichte sind laut Mistral „bis Ende Oktober" versprochen, ohne bestätigtes Datum; ein zeitlich begrenzter Launch-Rabatt von 50 % senkt den Preis bis etwa zum 20. Oktober auf 0,68 $/2,09 $ pro Million Input-/Output-Token.
Was Mistral Large 4 tatsächlich ist
Mistral Large 4 ist ein Mixture-of-Experts-Modell, das Mistral als „open-weight hybrid instruct-and-reasoning"-System mit multimodalem Input und reinem Text-Output beschreibt: Es nimmt Text und Bilder entgegen (bis zu 8 pro Anfrage, laut Mistrals eigener EU-AI-Act-Compliance-Unterlage), schreibt aber ausschließlich Text zurück, keine Bildgenerierung. Es enthält einen separaten Vision-Encoder mit 1,6 Milliarden Parametern für die Bildseite, ein Detail, das in Mistrals technischer Dokumentation bestätigt wird, aber im eigenen Blogpost des Unternehmens und in den meisten Presseberichten fehlt. Die API stellt einen Parameter reasoning_effort bereit, passend zur „Hybrid-Reasoning"-Einordnung: Man kann einstellen, wie viel das Modell nachdenkt, bevor es antwortet, und tauscht so Latenz gegen Qualität.
Mistral hat es auf rund 3.800 Nvidia-Grace-Blackwell-GPUs (Mistrals eigene Angabe; die Presse rundet das auf „etwa 4.000") über rund zwei Monate trainiert, abgedeckt werden über 160 Sprachen, darunter jede offizielle EU-Sprache. Mistrals VP of Science Pierre Stock sagte gegenüber TechCrunch, der Trainingslauf habe „zwei- bis dreimal weniger" Rechenleistung benötigt als bei nicht genannten chinesischen Konkurrenten, eine Effizienzbehauptung, die man als unternehmenseigene Angabe und nicht als unabhängig verifiziert einordnen sollte. Ein Detail, das man ernst nehmen sollte, bevor man das Modell anhand eines einzelnen Benchmarks zu hart beurteilt: Mistrals eigener Blog gibt an, dass das Reinforcement-Learning-Training beim Launch noch „in Arbeit" war, das Public-Preview-Checkpoint also ausdrücklich ein unfertiges Modell ist, nicht Mistrals finale Version.
Der Spitzname „Le Chonk" hat einen konkreten, nachprüfbaren Ursprung: Im Juni 2026 verbreitete sich online ein Scherz über ein fiktives Modell namens „Le Chaton Fat" mit erfundenen Benchmark-Werten von 30 Billionen Parametern. Mistral-CEO Arthur Mensch machte damals auf Social Media mit, und als Mistral Large 4 Monate später tatsächlich als wirklich überdimensioniertes Modell erschien, blieb der interne Spitzname hängen, Mensch soll scherzhaft gesagt haben, es sei „eigentlich le gros chaton". Ein kleines Detail, aber eines, das zeigt, dass Mistral sich seiner eigenen „großes Modell"-Positionierung dieses Mal bewusst ist, und ganz entspannt damit umgeht.
Die Gesamtparameterzahl hängt davon ab, welche Mistral-Seite man liest
Source                                Total params      Active params
---------------------------------------------------------------------------
Mistral's launch blog post             1 trillion         52 billion
docs.mistral.ai model page              1.05 trillion       52 billion
VentureBeat (launch-day reporting)      1 trillion          49 billion
EU AI Act technical documentation       ">1 trillion"       not disclosed
  (legal filing)

Mistral's blog and technical docs now agree on 52 billion active
parameters. The total count still varies across Mistral's own materials,
and VentureBeat's widely-repeated 49 billion figure doesn't appear in any
current Mistral-published page we could find.
Diese rechtliche Unterlage lohnt aus einem anderen Grund einen zweiten Blick. Mistrals EU-AI-Act-technische Dokumentation für nachgelagerte Anbieter, die für den Betrieb in der EU vorgeschriebene Compliance-Offenlegung, nennt für den maximalen Text-Input und -Output des Modells pauschal „250 Token". Diese Zahl ist mit ziemlicher Sicherheit ein Vorlagenfeld, das Mistral nie korrekt ausgefüllt hat, und kein echtes Limit (jede andere Quelle, einschließlich Mistrals eigener Dokumentation, nennt ein Kontextfenster im Bereich von Hunderttausenden bis einer Million Token), aber es ist eine echte, nachprüfbare Kuriosität in Mistrals offiziellen Unterlagen: Wir haben die Unterlage direkt gerendert, statt uns auf eine automatisierte Textextraktion zu verlassen, und die Zahl steht dort tatsächlich genau so. 250 Token sollte man nicht als echte Einschränkung zitieren; wohl aber als Zeichen werten, dass Mistrals Compliance-Dokumentation für diesen Launch in Eile entstanden ist.
Kontextfenster: 1 Million Token behauptet, rund die Hälfte davon gemessen
Mistrals eigene Dokumentation nennt ein Kontextfenster von 1.000.000 Token, die Zahl, die in den meisten Launch-Berichten wiederholt wird. Unabhängige API-Tracker messen in der Praxis etwas Kleineres: Vals.ai gibt ein Kontextfenster von 512.000 Token mit einem maximalen Output von 256.000 Token an, und Artificial Analysis' Spezifikations-Box und die eigene FAQ-Seite widersprechen sich mit 524.000 gegenüber 520.000 Token. Keine dieser drei unabhängigen Zahlen stimmt mit Mistrals Behauptung von 1 Mio. überein, und die beiden unabhängigen Tracker stimmen nicht einmal exakt untereinander überein. Wer einen Workflow darauf aufbauen will, das volle Millionen-Token-Fenster tatsächlich zu nutzen, sollte vorher mit einem eigenen langen Dokument testen; die Lücke zwischen behaupteter und gemessener Kapazität ist hier groß genug, um relevant zu sein.
Preise, und ein Rabatt, der schon herunterzählt
Tier                      Input ($/M tokens)   Output ($/M tokens)
---------------------------------------------------------------------
List price                 1.36                  4.18
Launch discount (50% off,   0.68                  2.09
  ~2 weeks from 6 Oct)
Cached input, discounted    0.07                  n/a

Mistral's own changelog states the discount runs roughly two weeks from
launch, putting the likely end date around 20 October 2026. No exact end
date is published on the pricing page itself, so confirm the live price
on Mistral's own console before relying on it.
Wie es abschneidet, unabhängig gemessen
Artificial Analysis, das jedes Modell durch denselben standardisierten Intelligence Index laufen lässt statt sich auf herstellerseitig gemeldete Werte zu verlassen, setzt Mistral Large 4 bei 38 an, Rang 65 von 216 erfassten Modellen, gegenüber einem Median der Kategorie von etwa 26-27. Das ist ein wirklich überdurchschnittliches Ergebnis und ein großer Sprung gegenüber Mistrals eigenem bisherigem Flaggschiff (dazu mehr unten), aber kein Spitzenergebnis: Claude Opus 5.5 führt die Liste mit 58 an, Claude Sonnet 5.5 liegt bei 51,9, und mehrere chinesische Open-Weight-Modelle, MiMo-V2.6-Pro (46), GLM-5.3 (45) und Qwen 3.8 Max (45,4), schneiden auf demselben Index alle besser ab als Mistral Large 4. Mistrals eigene Einordnung, „das stärkste Modell außerhalb der USA und Chinas", hält gegenüber westlichen Closed-Source-Konkurrenten wie GPT-6 Luna (etwa 37-38) stand, aber nicht gegenüber diesen chinesischen Open-Modellen, eine deutlich engere Behauptung, als die Schlagzeile vermuten lässt. Zum Vergleich: Der andere große Launch derselben Woche, die API-erreichbare Stufe von Metas Muse Wonder, erreicht auf demselben unabhängigen Index 52, deutlich vor Mistral Large 4.
Zwei unabhängige Zahlen sind wichtiger als der Headline-Score, wenn man entscheiden will, ob man dieses Modell tatsächlich einsetzt. Erstens die Halluzinationsrate: Artificial Analysis' AA-Omniscience-Messung setzt sie bei 41,9 % an, von der unabhängigen Prüferin eesel.ai als größte Schwachstelle dieses Launches markiert, wichtig zu wissen, bevor man es für irgendetwas einsetzt, bei dem eine falsche, aber selbstbewusst vorgetragene Antwort teuer würde. Zweitens die Latenz-Charakteristik: Sobald das Streaming beginnt, läuft der Output mit einer vernünftigen Geschwindigkeit von 116 Token pro Sekunde, aber die Time-to-first-Token bei langen Prompts wurde bei rund 18,7 Sekunden gemessen, schnell, sobald es läuft, langsam beim Start. Das ist eine schlechte Kombination für eine Live-Chat-Oberfläche und eine gute für einen Batch-Job, der eine Startverzögerung verträgt.
Vals.ai, ein separater unabhängiger Tracker mit einem anderen, stärker auf leistungsfähigere Spitzenmodelle ausgerichteten Vergleichsfeld, bewertet es relativ niedriger: 48,05 % auf dem Vals Index, Rang 35 von 47. Seine relativ beste Leistung zeigt es bei Harveys Legal Agent Benchmark, einer Aufgabe zu juristischen Dokumenten, bei der es Rang 9 von 79 belegt, eine respektable Platzierung, auch wenn der Rohwert (15,83 %) für sich genommen unbeeindruckend wirkt, da juristische Reasoning-Benchmarks dieser Art durchweg niedrig ausfallen. Seine schwächste Leistung zeigt es bei MysteryMechanism, wo es als Letzter abschneidet, Rang 27 von 27. Speziell bei Cybersicherheit brauchen Mistrals eigene, selbst gemeldete Zahlen (82-93 % bei Aufgaben zum Reproduzieren und Patchen von Schwachstellen) einen Vorbehalt, den Prüfer bei apidog direkt benannt haben: Claude Opus 5.5 und GPT-6 Astra erzielen beim selben selbst gemeldeten Vergleich nahe null, nicht weil sie die Aufgabe nicht lösen können, sondern weil sie sie aus Sicherheitsgründen verweigern. Das ist ein Methodenunterschied und keine reine Fähigkeitslücke, und Mistrals eigene Materialien machen diesen Unterschied nicht deutlich.
Mistral Large 4 vs. Mistral Large 3
                          Mistral Large 3        Mistral Large 4
------------------------------------------------------------------------
Total / active params      675B / 41B             ~1T-1.05T / 52B
Training hardware          3,000 Nvidia H200       3,800 Nvidia Blackwell
Released                    ~December 2025          6 October 2026
AA Intelligence Index       9                       38 (~4.2x higher)
Verbosity (output tokens     9.8M                    200M (~20x more
  to run full Index)                                  verbose)
Cost per Index task          $0.03                   $1.13 (~38x higher)

Intelligence Index, verbosity and cost figures are Artificial Analysis's
own independent measurements, not Mistral-reported.
Der Fähigkeitssprung von Large 3 zu Large 4 ist real und substanziell, nach Artificial Analysis' unabhängiger Messung etwa das 4-Fache des Intelligence-Index-Werts. Er kommt mit einem steilen Preis: Das Modell ist bei derselben Auswertung rund 20-mal geschwätziger, und der Preis für eine einzelne Intelligence-Index-Aufgabe stieg von 0,03 $ auf 1,13 $, rund das 38-Fache. Wer überlegt, einen auf Large 3 aufgebauten Workflow zu aktualisieren, sollte diesen Kostenanstieg explizit einplanen, statt anzunehmen, dass ein neueres, klügeres Modell automatisch günstiger pro Aufgabe läuft.
Offene Gewichte: „Ende Oktober", aber nicht bestätigt
Mistrals eigener Blog und Changelog beschreiben offene Gewichte beide als kommend „bis Ende des Monats" oder einfach „coming soon", ohne konkretes Datum. VentureBeats Berichterstattung nennt ein konkretes Zieldatum, den 27. Oktober 2026, eingeordnet als Ende einer rund dreiwöchigen Testphase mit Entwicklern, Cybersicherheitsforschern und Regierungsbehörden, aber dieses Datum ist VentureBeats eigene Schlussfolgerung aus Mistrals „Drei-Wochen"-Einordnung, kein von Mistral selbst veröffentlichtes Datum. TechCrunchs Berichterstattung ist noch vager und nennt lediglich „nur drei Wochen" nach dem Launch am 6. Oktober. Späten Oktober sollte man als grob richtig einordnen, den 27. Oktober konkret als unbestätigt. Auch die Lizenz für die eventuelle offene Veröffentlichung ist noch nicht final: VentureBeat berichtet, Mistral erwarte, eine eigene, benutzerdefinierte Mistral-Lizenz statt einer Standardlizenz wie Apache 2.0 oder MIT zu verwenden, aber auch das wurde noch nicht veröffentlicht, und der heutige Zugang wird ausschließlich durch Mistrals Nutzungsbedingungen und die Self-Deployment-Vereinbarung geregelt.
Wie man heute darauf zugreift
Aktuell ist der einzige bestätigte Weg, Mistral Large 4 zu nutzen, über Mistrals eigene API-Dokumentation oder die Mistral-Studio-Konsole, unter der Modell-ID mistral-large-4 (auf der Dokumentationsseite als mistral-large-4-0 gelistet). TechCrunch beschreibt den aktuellen Zugang ausdrücklich als beschränkt auf „a public guardrail endpoint", ein Punkt, den man im Kopf haben sollte, wenn man uneingeschränkten Zugang für eine sensible Workload braucht. Es ist außerdem bereits bei Drittanbieter-Gateways gelistet, darunter OpenRouter (als mistralai/mistral-large-4-0), Eden AI und LLMGateway. Wir konnten nicht bestätigen, ob es bereits in Vibe läuft, Mistrals eigener Consumer-Chat-App (im Mai 2026 von Le Chat umbenannt, wobei Konten und Abos übernommen wurden); Mistrals Ankündigung verlinkt zu Vibe, ohne zu sagen, dass das Modell dort verfügbar ist, also sollte man das direkt auf chat.mistral.ai prüfen, bevor man davon ausgeht, es dort kostenlos testen zu können.
Sollte man es nutzen
- EU-souveränes Hosting oder mehrsprachige Arbeit über offizielle EU-Sprachen hinweg: eine sinnvolle Wahl, und eines von Mistrals klarsten Unterscheidungsmerkmalen gegenüber US- und chinesischen Labs.
- Lange juristische oder Compliance-Dokumente: Die Platzierung bei Harveys Legal Agent Benchmark (Rang 9 von 79, unabhängig gemessen) deutet auf echte Stärke hin, auch wenn der Rohwert absolut betrachtet bescheiden ausfällt.
- Live-Chat oder latenzempfindliche Anwendungen: eine schwächere Wahl angesichts der rund 18,7 Sekunden Time-to-first-Token bei langen Prompts, auch wenn die Output-Geschwindigkeit, sobald es läuft, in Ordnung ist.
- Alles, bei dem eine selbstbewusst vorgetragene, aber falsche Antwort teuer wird: Die unabhängig gemessene Halluzinationsrate von 41,9 % ist die unter Prüfern am häufigsten genannte Schwachstelle; Ausgaben lieber prüfen statt ihnen blind zu vertrauen.
- Hochmodernes Coding oder latenzempfindliche agentische Arbeit: eine schwächere Wahl. Sein Artificial-Analysis-Intelligence-Index (38) liegt hinter mehreren chinesischen Open-Modellen (MiMo-V2.6-Pro bei 46, GLM-5.3 bei 45, Qwen 3.8 Max bei 45,4), die ebenfalls Open-Weight sind, ein Vergleich, der für Entwickler bei der Wahl eines Coding-Modells wahrscheinlich am stärksten zählt.
Häufig gestellte Fragen
Ist Mistral Large 4 kostenlos?
Es gibt keine kostenlose Stufe. Es ist nur über die API verfügbar, pro Token abgerechnet, mit einem zeitlich begrenzten Launch-Rabatt von 50 % (rund 0,68 $/2,09 $ pro Million Input-/Output-Token), der laut Mistrals eigenem Changelog etwa zwei Wochen ab dem Launch am 6. Oktober 2026 läuft.
Ist Mistral Large 4 Open Source oder Open Weight?
Noch nicht. Mistral beschreibt es als für Open Weight vorgesehen und verspricht die Gewichte „bis Ende Oktober" 2026, wobei VentureBeat ein konkretes, aber unbestätigtes Zieldatum vom 27. Oktober berichtet. Die Lizenz ist noch nicht final; Mistral erwartet, eine eigene, benutzerdefinierte Lizenz statt einer Standardlizenz wie Apache 2.0 zu verwenden.
Wie viele Parameter hat Mistral Large 4?
52 Milliarden aktive Parameter, eine Zahl, auf die sich Mistrals eigener Blog und die technische Dokumentation inzwischen einigen. Die Gesamtparameterzahl variiert in Mistrals eigenen Materialien weiterhin: 1 Billion laut Launch-Blog, 1,05 Billionen laut technischer Dokumentation. VentureBeats Berichterstattung am Launch-Tag nannte separat 49 Milliarden aktive Parameter, eine Zahl, die sich in keiner aktuellen Mistral-eigenen Seite findet.
Wie groß ist Mistral Large 4s tatsächliches Kontextfenster?
Mistral nennt 1 Million Token. Unabhängige Tracker messen in der Praxis weniger: Vals.ai gibt 512.000 Token an, und Artificial Analysis' eigene Spezifikations-Box und FAQ widersprechen sich mit 524.000 gegenüber 520.000 Token.
Wie schneidet Mistral Large 4 im Vergleich zu Mistral Large 3 ab?
Rund das 1,5-Fache der Gesamtparameter auf neuerer Nvidia-Blackwell-Hardware. Unabhängig gemessen sieht Artificial Analysis einen Sprung von etwa dem 4-Fachen beim Intelligence-Index-Wert (9 auf 38), allerdings mit rund 20-mal höherer Output-Geschwätzigkeit, und die Auswertungskosten pro Aufgabe steigen von 0,03 $ auf 1,13 $, rund das 38-Fache.
Halluziniert Mistral Large 4 stark?
Artificial Analysis' AA-Omniscience-Messung setzt die Halluzinationsrate bei 41,9 % an, von der unabhängigen Prüferin eesel.ai als größte Schwachstelle des Modells markiert. Faktische Ausgaben sollte man prüfen statt ihnen blind zu vertrauen, besonders bei unbekannten oder Nischenthemen.
Worin ist Mistral Large 4 am stärksten?
Unabhängig gemessene Stärken umfassen juristische und Langdokument-Arbeit (eine respektable Platzierung bei Harveys Legal Agent Benchmark) sowie Aufgaben zur Reproduktion von Cybersicherheits-Schwachstellen, wobei Mistrals selbst gemeldete Cyber-Werte den Vorbehalt brauchen, dass manche Konkurrenzmodelle beim selben Test nahe null erzielen, weil sie die Aufgabe aus Sicherheitsgründen verweigern, nicht weil sie sie nicht lösen können.