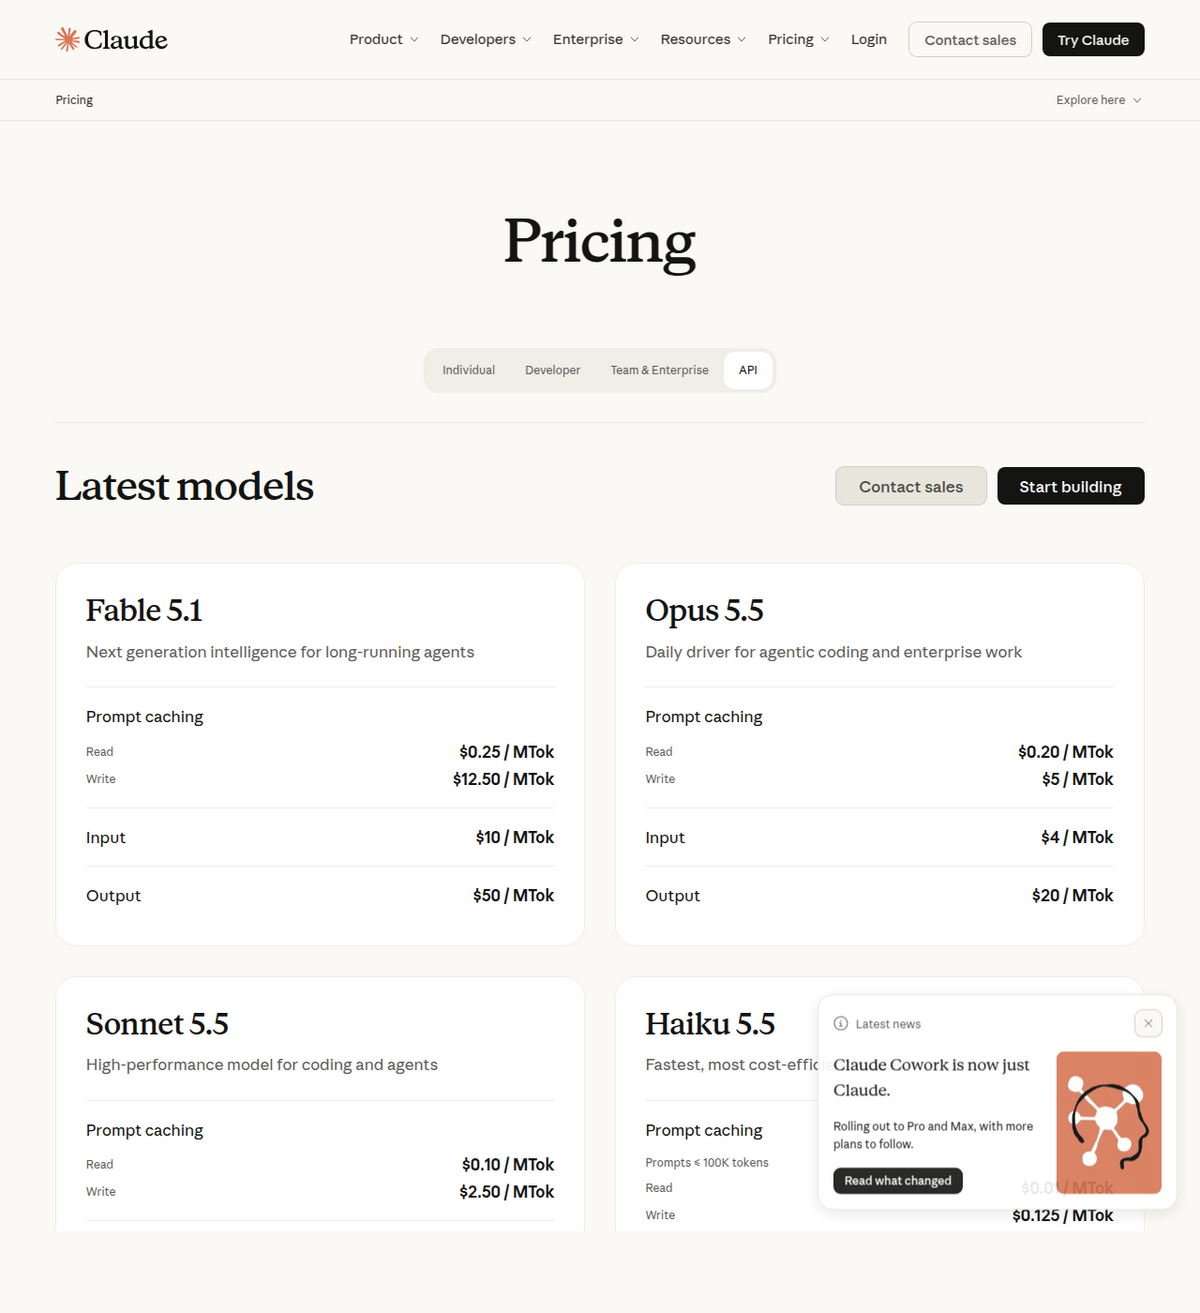
Claude Sonnet 5.5 se lanzó el 28 de septiembre de 2026, el segundo lanzamiento de la renovación "5.5" de Anthropic, seis días después de Opus 5.5 (22 de septiembre). El precio no cambia respecto a Sonnet 5: 2 $ por millón de tokens de entrada, 10 $ por millón de tokens de salida. El único precio que sí cambió es fácil de pasar por alto: las lecturas de caché de prompts bajaron a 0,10 $ por millón de tokens, la mitad de los 0,20 $ anteriores de Sonnet 5. La mayoría de los rastreadores de precios de terceros que comprobamos todavía indican 0,20 $ como vigente.
En benchmarks de trabajo de conocimiento y uso de ordenador, es casi un empate con Opus 5.5 a mitad de precio. Sonnet 5.5 puntúa 1844 en GDPval-AA v2.1 frente a los 1846 de Opus, y 80,1% en OSWorld 2.1 frente al 81,8% de Opus, diferencias de uno a dos puntos a pesar de que el precio es el doble.
La propia cifra de Anthropic y la repetición de la prueba de un laboratorio independiente no coinciden. Anthropic reporta 70,6% en Terminal-Bench 4.0; la repetición independiente del mismo benchmark por parte de Artificial Analysis obtuvo 64%, todavía por delante del 60% de Opus 5.5 en el mismo entorno de pruebas de AA, pero es una diferencia real entre la cifra de marketing y los resultados reproducidos que conviene conocer antes de planificar nada en torno a ella.
La afirmación de "hasta un 30% más barato" no se sostiene en todos los ajustes. Al máximo esfuerzo de razonamiento, Sonnet 5.5 genera en promedio unos 193.000 tokens de salida por tarea, la cifra más alta que Artificial Analysis ha medido para cualquier modelo, lo que eleva su coste por tarea a unos 7,60 $, más que Sonnet 5 y, en una medición, más que Opus 5.5 alcanzando el mismo nivel de calidad con menos tokens, aunque más caros.
Qué se lanzó, y en qué orden
Nuestra propia guía de Opus 5.5 indicaba el orden contrario hasta que lo corregimos al investigar este artículo. La propia documentación de modelos de Anthropic indica el lanzamiento de Opus 5.5 el 22 de septiembre de 2026 y el de Sonnet 5.5 el 28 de septiembre de 2026, seis días después, no antes. El orden importa para cómo interpretar la comparación: Sonnet 5.5 es el acto de seguimiento que tenía que superar las cifras de benchmark de Opus 5.5, no el previo.
El identificador del modelo en la API es claude-sonnet-5-5, disponible a través de la API de Claude, Amazon Bedrock, Google Cloud Vertex AI y Microsoft Foundry. La ventana de contexto se mantiene en 1 millón de tokens, con un límite de salida de 128K tokens en solicitudes estándar, ampliable a 300K tokens en la Batch API mediante la cabecera beta output-300k-2026-03-24. El corte de conocimiento es junio de 2026, tanto para el entrenamiento como para la recuperación fiable de datos. Un valor por defecto de comportamiento cambió respecto a Sonnet 5: Sonnet 5.5 razona por defecto con esfuerzo alto (Opus 5.5 usa medio por defecto), y su ajuste manual de pensamiento más bajo ahora es between_tools en lugar de la antigua opción disabled, un cambio que rompe la compatibilidad si tu integración desactivaba explícitamente el pensamiento.
El matiz del precio: las lecturas de caché se abarataron, y la mayoría de rastreadores no se enteró
El precio de entrada y salida se mantiene igual que en Sonnet 5: 2 $ por millón de tokens de entrada, 10 $ por millón de salida. Donde algo sí cambió realmente es en la caché de prompts. La documentación de Anthropic afirma que Sonnet 5.5 mantiene los mismos precios que Sonnet 5, "excepto las lecturas de caché de prompts, que cuestan 0,10 $ USD por millón de tokens, la mitad de la tarifa de Claude Sonnet 5". Las escrituras de caché se mantienen en 2,50 $/millón para una caché de 5 minutos y 4 $/millón para una de 1 hora. La Batch API sigue aplicando un descuento del 50% sobre entrada y salida, lo que equivale a 1 $/5 $ por millón de tokens para cargas de trabajo asíncronas.
Revisamos varios resúmenes de precios publicados tras el lanzamiento de Sonnet 5.5, y más de uno, incluida la guía de precios de eesel.ai, todavía indica 0,20 $ en las lecturas de caché, la cifra antigua de Sonnet 5, en lugar de los 0,10 $ corregidos. Si estás presupuestando una carga de trabajo con una alta tasa de aciertos de caché, la diferencia se acumula: una carga que lee sobre todo de caché cuesta aproximadamente la mitad de lo que sugeriría una tabla desactualizada. Comprueba cualquier afirmación de precio directamente contra la documentación de Anthropic en vez de una tabla secundaria, incluida esta, antes de comprometer un presupuesto con ella.
Benchmarks: casi un empate con Opus, con una brecha entre el proveedor y los resultados independientes
Benchmark                    Sonnet 5.5   Opus 5.5   Sonnet 5
----------------------------------------------------------------
GDPval-AA v2.1 (knowledge work)    1844         1846        1449
OSWorld 2.1 (partial credit)       80.1%        81.8%       57.0%
OSWorld 2.1 (strict pass)          43.5%        48.7%       25.6%
Terminal-Bench 4.0 (Anthropic)     70.6%        66.4%       10.3%
Terminal-Bench 4.0 (AA re-test)      64%          60%          -
FrontierCode 1.1 (xhigh effort)    52.1%        54.4%       42.4%
CursorBench 4.0                    55.5%        57.8%       34.1%
Humanity's Last Exam (w/ tools)    64.5%        67.7%       54.9%

AA = Artificial Analysis, an independent benchmark lab.
Terminal-Bench shows the largest vendor-vs-independent gap of
any figure checked for this article.
En GDPval-AA, un benchmark de trabajo de conocimiento, y en OSWorld, una prueba de manejo de un ordenador real a través de una interfaz gráfica, Sonnet 5.5 se queda a uno o dos puntos de Opus 5.5 a pesar de costar la mitad. Ese es el titular con el que abre la mayoría de la cobertura, y es correcto. Lo que la mayoría de la cobertura se salta es el desglose de OSWorld: la cifra del 80,1% es crédito parcial, que premia el avance hacia una tarea aunque no se complete del todo. La tasa de aprobado estricto, solo finalización completa de la tarea, es del 43,5% para Sonnet 5.5 frente al 48,7% de Opus 5.5, una diferencia que se amplía de 1,7 puntos en crédito parcial a 5,2 puntos en aprobado estricto, una cifra bastante distinta a tener en cuenta si tu caso de uso necesita una tarea terminada y no solo casi terminada.
La brecha de Terminal-Bench merece señalarse por separado. Los materiales de lanzamiento de Anthropic reportan 70,6% para Sonnet 5.5. Artificial Analysis, un laboratorio independiente que repite los benchmarks en su propio entorno de pruebas en lugar de aceptar las cifras del proveedor sin más, midió 64%, una caída de seis puntos respecto a la cifra del proveedor, aunque todavía por delante del 60% de Opus 5.5 en el mismo entorno. Ninguna de las dos cifras es exactamente incorrecta; reflejan condiciones de prueba distintas. Pero una diferencia de seis puntos entre lo que reporta una empresa y lo que reproduce un tercero independiente es el tipo de detalle que debería aparecer en cualquier comparación seria, y estuvo prácticamente ausente en las páginas de la competencia que revisamos.
Un hilo de Hacker News sobre el lanzamiento (884 puntos, 613 comentarios) planteó un matiz relacionado: parte de la ventaja de Sonnet 5.5 sobre Opus 5.5 en algunos benchmarks agénticos podría reflejar el comportamiento de enrutamiento de seguridad de Opus más que una diferencia pura de capacidad. Un comentarista citó que Opus 5.5 recurre a un modelo más débil en aproximadamente el 10% de los intentos por activación de salvaguardas, muy por encima de la tasa de recurso de Sonnet en las mismas pruebas. Es una observación de la comunidad, no una cifra confirmada por Anthropic, pero es una explicación plausible de por qué un modelo más barato sigue casi igualando o superando a uno más caro en pruebas concretas.
La historia real del coste: la verbosidad de tokens al máximo esfuerzo
Anthropic promociona Sonnet 5.5 como un modelo que completa tareas hasta un 30% más barato que Sonnet 5. Esa afirmación es real para la combinación de tareas y el nivel de esfuerzo que eligió Anthropic, pero no se sostiene de forma universal, y esa diferencia es el dato más útil de todo este artículo para quien de verdad paga la factura. Artificial Analysis midió que Sonnet 5.5 genera en promedio unos 193.000 tokens de salida por tarea al máximo esfuerzo de razonamiento, la cifra más alta que AA ha registrado para cualquier modelo que sigue, alrededor de un 60% más que Opus 5.5 o Sonnet 5 en el mismo ajuste de esfuerzo máximo, y aproximadamente siete veces la verbosidad de GPT-6 Astra en tareas comparables.
Esa verbosidad se traduce directamente en coste por tarea: AA midió a Sonnet 5.5 en unos 7,60 $ por tarea al máximo esfuerzo, alrededor de un 50% más que el coste de Sonnet 5 en el mismo ajuste. En una comparación de AA, Opus 5.5 alcanzó la puntuación de calidad máxima de Sonnet 5.5 por unos 3,46 $ por tarea, necesitando menos tokens, aunque más caros, en lugar de muchos más baratos, resultando en total más barato que la propia ejecución de Sonnet 5.5 al esfuerzo máximo. La lección práctica: la ventaja de precio de Sonnet 5.5 es real en su ajuste de esfuerzo alto por defecto para tareas bien delimitadas, y puede desaparecer o invertirse si lo llevas al esfuerzo máximo en algo genuinamente difícil, donde los tokens de Opus 5.5, menos numerosos pero más caros, a veces terminan el trabajo por menos dinero.
Sonnet 5.5 frente a Opus 5.5: qué te dice la propia Anthropic que compres
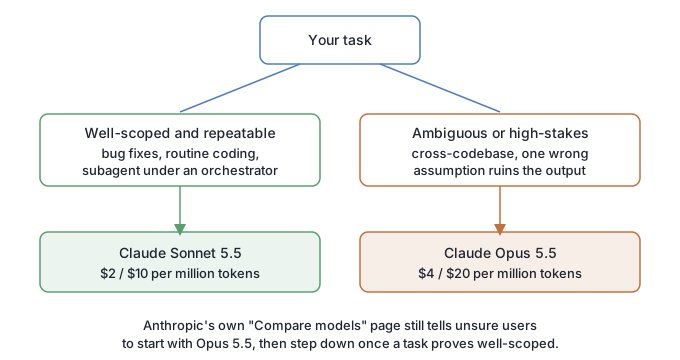
Anthropic no posiciona a Sonnet 5.5 como un sustituto de Opus 5.5. Su propio anuncio describe a Sonnet 5.5 como "un complemento más rápido y de menor coste para Claude Opus 5.5", reservando Opus para "trabajo complejo que requiere un juicio cuidadoso". La tabla comparativa de modelos de la documentación es todavía más directa: les dice a los usuarios indecisos que empiecen con Opus 5.5 para la mayoría de cargas de trabajo, y trata a Sonnet como el modelo al que se baja una vez que ya sabes que una tarea está bien delimitada, no como la opción por defecto.
Detrás de esa recomendación hay una compensación de precisión genuina que las tablas de benchmarks no muestran directamente. En la prueba Omniscience de Artificial Analysis, una medida de precisión factual, Opus 5.5 puntúa 66% frente al 54% de Sonnet 5.5: Opus simplemente conoce correctamente más hechos. Pero en tasa de alucinación, Sonnet 5.5 es en realidad más bajo (mejor) con 47% frente al 59% de Opus: cuando Sonnet 5.5 no sabe algo, es más probable que lo admita en vez de adivinar, aunque tenga menos con lo que trabajar en conjunto. Para la síntesis de investigación en concreto, una tasa de alucinación más baja en lo que sí intenta responder puede importar más que un techo de conocimiento bruto más alto, según prefieras detectar un vacío de información o detectar una respuesta incorrecta dicha con total confianza.
La queja que domina el debate entre desarrolladores: las salvaguardas bloqueando trabajo normal
El tema recurrente más sonado en ese hilo de Hacker News no fue el precio ni los benchmarks, sino el sistema de salvaguardas cibernéticas de Anthropic marcando como arriesgado trabajo legítimo. Los desarrolladores reportaron quedar bloqueados o redirigidos a un modo restringido en tareas como firmware Bluetooth para ESP32, revisión de código C antiguo, implementaciones de write-ahead-log e investigación autorizada de bug-bounty. El resumen de un comentarista, "no quiero una herramienta niñera", se repitió varias veces en el hilo, junto con quejas de que el "Cyber Verification Program" subyacente produce falsos positivos sin una vía clara de apelación.
Un segundo grupo de quejas se centró en los límites de uso más que en el enrutamiento de seguridad: varios usuarios reportaron agotar las cuotas del plan Max mucho antes de que se renovara el periodo de facturación, uno de ellos citando un plan Opus 5.5 20x agotado en cuatro de siete días, y otro relato por separado de un equipo que agotó un presupuesto mensual de 10.000 $ en tokens en menos de un día de uso agéntico intensivo. Ninguna de las dos quejas es específica de las capacidades de Sonnet 5.5, pero ambas afectan al coste práctico de adoptarlo dentro de un flujo de trabajo agéntico, y ninguna aparece en una gráfica de benchmark.
Una comparación realizada de forma independiente da una idea más concreta de la fiabilidad en el mundo real. La plataforma de revisión de código CodeRabbit probó a Sonnet 5.5 contra Sonnet 5 en 13 pull requests con errores conocidos y previamente catalogados: Sonnet 5.5 detectó 6 de 13 frente a los 4 de 13 de Sonnet 5, con un coste por revisión aproximadamente un 60% menor y alrededor de la mitad de latencia (una media de 5 minutos y 27 segundos frente a 9 minutos y 55 segundos). Opus 5.5 siguió detectando más, entre 8 y 10 de los mismos 13 errores según la ejecución. Eso coincide con el patrón que describe el propio posicionamiento de Anthropic: Sonnet 5.5 es una mejora real sobre Sonnet 5 al mismo precio, y Opus 5.5 sigue detectando más en los casos que más importan.
Sonnet 5.5 frente al resto del mercado: GPT-6 Sol y el problema de Pareto
GPT-6 Sol de OpenAI tiene el mismo precio que Sonnet 5.5, 2 $/10 $ por millón de tokens, lo que convierte a ambos en un cara a cara directo en coste. Sonnet 5.5 lidera con claridad en GDPval-AA (1844 frente a 1487) y en AA-Briefcase (1811 frente a 1483), y se adelanta ligeramente en FrontierCode (52,1% frente a 49,3%). Pero Artificial Analysis señala que Sonnet 5.5 queda fuera de la frontera de inteligencia por token de salida a precio equiparado, por el mismo problema de verbosidad descrito antes: GPT-6 Sol entrega más capacidad medida por token de salida a un precio comparable, incluso donde Sonnet 5.5 gana en puntuaciones brutas de benchmark. Cuál de los dos cuesta realmente menos en producción depende en gran medida de cuánta verbosidad permita tu carga de trabajo concreta, no solo de la tabla de benchmarks destacada.
Quién debería usar realmente Sonnet 5.5
- Usa Sonnet 5.5 si tu carga de trabajo está bien delimitada y es repetible: programación rutinaria, corrección de errores con un caso de reproducción claro, o un subagente que corre bajo un orquestador de nivel Opus. Aquí es donde sus puntuaciones casi a la altura de Opus a mitad de precio de verdad compensan.
- Usa Sonnet 5.5 si ya estabas en Sonnet 5 y no has cambiado nada. La actualización es, en la práctica, gratuita en el alias de modelo
sonnet, y las pruebas independientes (la comparación de revisión de PR de CodeRabbit, una prueba práctica aparte de un agente editor) muestran un salto de calidad real al mismo precio. - Sube a Opus 5.5 si la tarea es ambigua, abarca una base de código poco familiar, o una sola suposición equivocada saldría cara. La ventaja de Opus sobre Sonnet se amplía precisamente en estos casos más difíciles y menos delimitados.
- No asumas "hasta un 30% más barato" al esfuerzo máximo. Si llevas Sonnet 5.5 a su ajuste de razonamiento más alto en problemas genuinamente difíciles, comprueba tu gasto real en tokens. Las mediciones independientes encontraron que puede costar más que Sonnet 5, y a veces más que Opus 5.5 llegando al mismo resultado.
- Presupuesta las cargas de trabajo intensivas en caché usando 0,10 $/millón para las lecturas, no la cifra de 0,20 $ que varios rastreadores de precios todavía publican.
La gente también pregunta
¿Cuándo se lanzó Claude Sonnet 5.5, antes o después de Opus 5.5?
El 28 de septiembre de 2026, seis días después de Claude Opus 5.5 (22 de septiembre de 2026), no antes. Una versión anterior de nuestra propia guía de Opus 5.5 tenía el orden invertido; lo corregimos tras verificarlo con la propia documentación de Anthropic.
¿Cuánto cuesta Claude Sonnet 5.5?
2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida, sin cambios respecto a Sonnet 5. Las lecturas de caché de prompts cuestan 0,10 $ por millón de tokens, la mitad de la tarifa anterior de 0,20 $ de Sonnet 5, un cambio que varios rastreadores de precios de terceros todavía no han actualizado. La Batch API aplica un descuento del 50% sobre el precio estándar.
¿Es Claude Sonnet 5.5 tan bueno como Opus 5.5?
En GDPval-AA (trabajo de conocimiento) y OSWorld (uso de ordenador), Sonnet 5.5 puntúa a uno o dos puntos de Opus 5.5 a pesar de costar la mitad. Opus 5.5 se adelanta en benchmarks más difíciles y menos delimitados, y en precisión factual (66% frente a 54% en AA-Omniscience), mientras que Sonnet 5.5 en realidad alucina menos cuando no sabe una respuesta (47% frente a 59%).
¿Es Claude Sonnet 5.5 realmente hasta un 30% más barato que Sonnet 5?
Para la combinación de tareas y el nivel de esfuerzo por defecto que eligió Anthropic, sí. Al máximo esfuerzo de razonamiento, las pruebas independientes encontraron que Sonnet 5.5 genera muchos más tokens de salida por tarea que Sonnet 5, lo que eleva su coste por tarea alrededor de un 50% más que Sonnet 5 en ese ajuste, y a veces más que Opus 5.5 alcanzando la misma calidad con menos tokens.
¿Por qué se queja la gente de las salvaguardas cibernéticas de Claude en Sonnet y Opus 5.5?
Los desarrolladores han reportado que trabajo legítimo, código de firmware, revisión de C antiguo, investigación de seguridad autorizada, acaba marcado o restringido por el Cyber Verification Program de Anthropic. La queja no trata de una respuesta incorrecta concreta; trata de falsos positivos que interrumpen trabajo de desarrollo normal sin una vía clara para resolverlos.