Qwen3.8 Max puntúa más alto en el Intelligence Index de Artificial Analysis (45 frente a 36), pero cuesta aproximadamente un 70% más y genera salida a menos de la mitad de la velocidad de DeepSeek (42 frente a 99 tokens por segundo), según el comparativo actual de Artificial Analysis, verificado hoy.
Los pesos de DeepSeek V4 Pro tienen licencia MIT y son descargables. La API alojada de Qwen3.8 Max es propietaria, e incluso el checkpoint de pesos abiertos publicado por separado detrás de ella lleva una licencia personalizada, no Apache, con un gatillo de ingresos comerciales, no la licencia permisiva por la que se conocen los modelos más pequeños de Qwen.
En programación agéntica y uso de terminal, DeepSeek es competitivo o va por delante: supera a Qwen en SciCode y pierde claramente en Terminal-Bench 4.0 (14% frente a 39%). Qwen lidera por un margen amplio en conocimiento general y en benchmarks de trabajo de conocimiento agéntico.
DeepSeek tiene un descuento integrado en horas de menor demanda, aproximadamente un 50% más barato en entrada y salida, que se aplica por defecto durante la mayor parte de la semana; el precio completo solo entra en vigor en dos franjas horarias estrechas en días laborables en UTC. El precio de Qwen es plano a todas horas.
Los buques insignia, a octubre de 2026
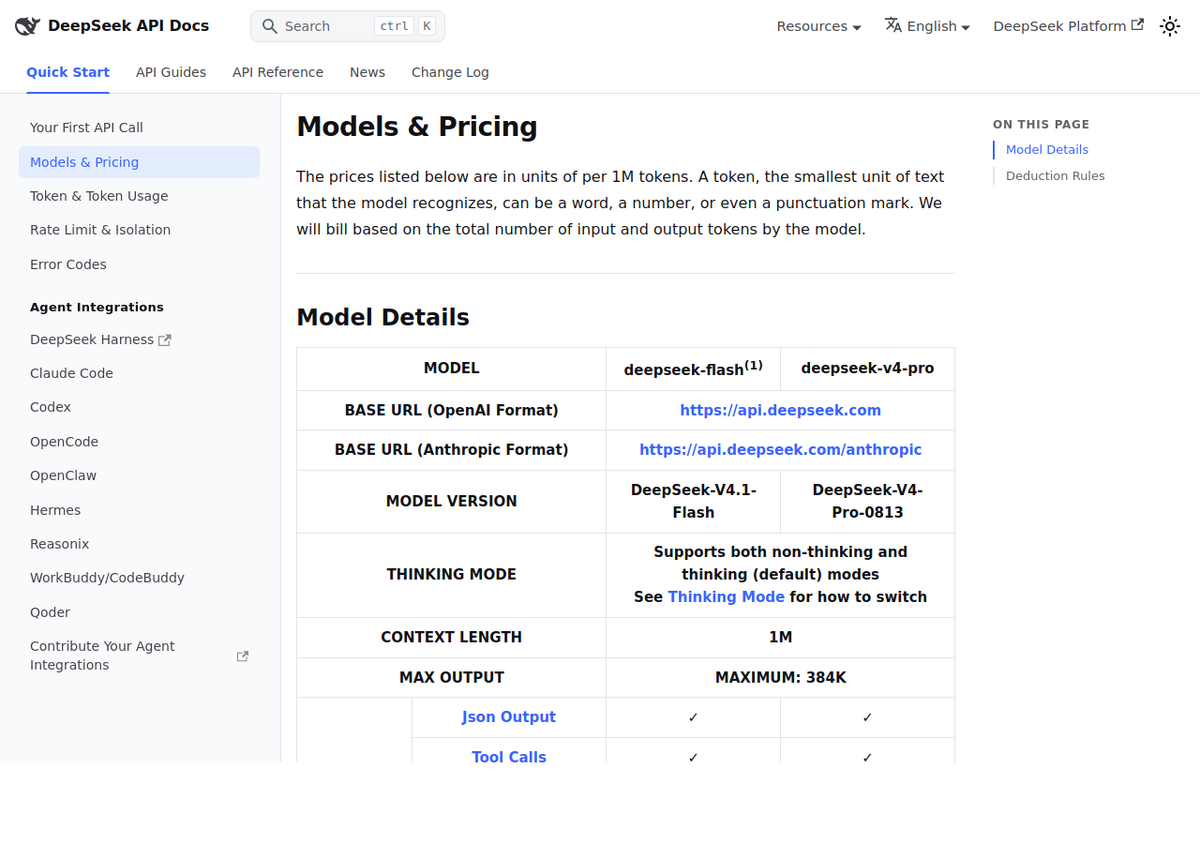
Ambas empresas publican bajo números de versión que cambian con la frecuencia suficiente para confundir los resultados de búsqueda, así que merece la pena precisar qué build cubre esta comparativa. DeepSeek-V4-Pro-0813 es la versión de disponibilidad general que la propia documentación de la API de DeepSeek lista hoy, fechada por su sufijo de versión al 13 de agosto de 2026; siguió a una vista previa de abril de 2026 que muchas páginas de comparación más antiguas (incluidas algunas que todavía posicionan bien) están midiendo en realidad en su lugar. Según la ficha de modelo de NIM de NVIDIA, es un modelo de mezcla de expertos con 1,6 billones de parámetros totales y 49.000 millones activos por token, 384 expertos enrutados con 6 seleccionados por token, una ventana de contexto de 1 millón de tokens y una salida máxima de 384.000 tokens. Una fuente secundaria indica 1,7 billones totales en lugar de 1,6 billones en la ficha de disponibilidad general; no pudimos confirmar esa discrepancia contra el propio informe técnico de DeepSeek, y lo señalamos aquí en lugar de elegir una cifra solo para sonar más precisos de lo que la evidencia respalda.
Qwen3.8-Max-0902 es el buque insignia actual de Alibaba, una actualización de septiembre de 2026 de la línea Qwen3.8-Max que se lanzó por primera vez el 3 de agosto de 2026. Es un modelo de mezcla de expertos disperso reportado con 2,4 billones de parámetros totales y aproximadamente 95.000 millones activos por token (512 expertos, 10 seleccionados por token, según varios rastreadores independientes; las propias páginas de Alibaba no publican el número de expertos directamente). Artificial Analysis indica su ventana de contexto en 984.000 tokens, esencialmente la misma clase práctica de 1M de tokens que DeepSeek, ampliada desde una ventana nativa menor. A diferencia de DeepSeek, Qwen3.8 Max también acepta entrada de imagen a través de la API alojada; DeepSeek V4 Pro es solo texto.
Precios: cifras oficiales, no estimaciones de agregadores
DeepSeek publica el precio directamente en su propia documentación de API, diferenciado según si lo usas en horas de menor o mayor demanda en UTC. Alibaba publica el precio de Qwen3.8-Max en su propia página de precios de Model Studio, en CNY, por niveles según la región de despliegue: el precio de China/por defecto global es notablemente más barato que el despliegue internacional en Singapur/EE. UU. que realmente usará la mayoría de desarrolladores fuera de China.
Per 1M tokens              DeepSeek V4 Pro-0813      Qwen3.8 Max-0902
-----------------------------------------------------------------------
Input (peak hours)          $1.32                      $2.00
Input (off-peak, DeepSeek   $0.66                      n/a (flat rate)
  only, see note below)
Output (peak hours)         $3.96                      $6.00
Output (off-peak)           $1.98                      n/a
Cache hit                   $0.044                     $0.25
Blended (AA's 7:2:1 ratio)  $0.69                       $1.18

DeepSeek peak window (full price): 01:00-04:00 and 06:00-10:00 UTC,
Monday through Friday, excluding Chinese public holidays. Every other
hour, including weekends, bills at the cheaper off-peak rate. Source:
DeepSeek's own API docs, api-docs.deepseek.com/quick_start/pricing.
Qwen figures are the Singapore/US international deployment tier, converted
from Alibaba's own CNY 14.988 / CNY 44.965 per-million rate (Alibaba's
China/global-default tier is roughly 20% cheaper at CNY 12 / CNY 36).
Source: help.aliyun.com/en/model-studio/model-pricing, checked 14 Oct 2026.
También hay un nivel económico en cada lado que merece la pena conocer si el precio del buque insignia es más de lo que necesitas: deepseek-flash de DeepSeek (DeepSeek-V4.1-Flash) cuesta 0,15 $/0,6 $ en horas de mayor demanda y 0,075 $/0,3 $ fuera de ellas por millón de tokens de entrada/salida, aproximadamente una novena parte del coste del buque insignia, con la misma ventana de contexto de 1M. El alias heredado qwen-max de Alibaba tiene un precio igualmente reducido en su nivel China/por defecto global, en CNY 2,4/9,6 por millón de tokens, una quinta parte del propio CNY 12/36 del nivel China de Qwen3.8 Max, pero es un modelo solo sin razonamiento, sin precios escalonados por longitud de contexto, una cadena de modelo fácil de copiar por error si estás reutilizando una guía de integración antigua.
Benchmarks: en qué gana realmente cada uno
Artificial Analysis ejecuta un comparativo directo entre los buques insignia actuales, ambos configurados al máximo esfuerzo de razonamiento, puntuados con su Intelligence Index v4.3.2. Qwen3.8 Max lidera en inteligencia general y en la mayoría de tareas de trabajo de conocimiento agéntico; DeepSeek V4 Pro está cerca o por delante en benchmarks relacionados con programación, y es dramáticamente más barato y rápido en todo.
Benchmark (max effort)                 Qwen3.8 Max-0902    DeepSeek V4 Pro-0813
---------------------------------------------------------------------------
Intelligence Index (v4.3.2)             45                   36
Terminal-Bench 4.0 (agentic terminal)   39%                  14%
SciCode (coding)                        52%                  51%
AA-Briefcase v1.1 (agentic knowledge)   1617                 1257
GDPval-AA v2.1 (agentic real work)      1667                 1449
AutomationBench-AA (agentic SaaS)       56%                  57%
Humanity's Last Exam                    43%                  41%
GDP.pdf                                 23%                  11%
CritPt (physics reasoning)              18%                  18%
AA-Omniscience                          12                   1
AA-LCR v1.1 (long-context reasoning)    80%                  80%
Output speed (tokens/sec)               42                   99

Source: artificialanalysis.ai/models/comparisons/deepseek-v4-pro-vs-qwen3-8-max,
checked 14 Oct 2026. Note: Artificial Analysis publishes several versions of
this comparison at different DeepSeek reasoning-effort settings (High vs.
Max); scores shift by several points between them, so if you see different
numbers elsewhere, check which effort setting the page is showing.
El patrón que se mantiene en ambas tablas: Qwen gana en tareas que premian el conocimiento amplio y la planificación agéntica de varios pasos (Terminal-Bench, AA-Briefcase, GDPval-AA, AA-Omniscience), mientras que ambos están prácticamente igualados en programación en bruto (SciCode) y en recuperación de contexto largo (AA-LCR, ambos al 80%). Ninguno de los dos modelos publica un benchmark específico de matemáticas en esta comparación. Si tu carga de trabajo se parece más a "escribir y depurar código" que a "planificar y ejecutar una tarea agéntica de varios pasos", la brecha de benchmarks importa mucho menos que la diferencia de precio del 70%.
Licencia: el punto que la mayoría de comparativas entiende mal
Los pesos de DeepSeek V4 Pro se reportan con licencia MIT, coherente con los lanzamientos anteriores V3 y R1 de DeepSeek, según su ficha en NVIDIA NIM y rastreadores independientes de modelos (no pudimos extraer el archivo de licencia directamente del propio repositorio de Hugging Face de DeepSeek para confirmar el texto exacto, así que trátalo como bien respaldado pero no verificado en fuente primaria). MIT es casi lo más permisivo que existe en licencias: uso comercial, modificación y redistribución sin ningún límite de ingresos.
Qwen3.8 Max es una historia distinta, y es donde buena parte de la cobertura de "Qwen es de código abierto" exagera las cosas. El modelo de la API alojada es propietario, sin más, igual que Gemini o GPT. Alibaba sí publicó por separado un checkpoint de pesos abiertos detrás de él, reportado con el nombre Qwen3.8-2.4T-A95B, en Hugging Face alrededor del 12 de agosto de 2026, solo texto y limitado al modo de razonamiento (la entrada de visión y el modo sin razonamiento que sí ofrece la API alojada no están en la versión abierta). Pero ese checkpoint se publica bajo una licencia personalizada, "Qwen3.8-Max license", no Apache 2.0, y varios rastreadores reportan que incluye una excepción de uso comercial que exige un acuerdo separado una vez que los ingresos de los últimos 12 meses de la empresa que lo despliega superan los 50 millones de dólares en ciertas categorías de servicios de IA. Es un trato materialmente distinto al del modelo denso más pequeño de Qwen, Qwen3.8-27B, que es Apache 2.0, sin umbral de ingresos. No pudimos extraer el texto exacto de la licencia para citar sus términos literalmente, así que verifica el archivo de licencia actual en Hugging Face directamente antes de construir una dependencia de producción sobre él. La conclusión práctica: "Qwen es de pesos abiertos" es cierto para los modelos más pequeños de Qwen y falso, o al menos muy matizado, para su buque insignia real de 2,4 billones de parámetros.
Dónde puedes ejecutarlos de verdad
- Ambos proveedores ofrecen acceso directo por API: api.deepseek.com (endpoints compatibles con OpenAI y Anthropic) y Alibaba Cloud Model Studio para Qwen, facturados como se muestra arriba.
- AWS añadió DeepSeek-V3.1 y varios modelos Qwen3 a Bedrock como ofertas totalmente gestionadas en 2025 (según el propio anuncio de Amazon): DeepSeek-V3.1 y Qwen3-Coder-480B en US East (Ohio) y AP (Jakarta), con Qwen3-32B, Qwen3-235B y Qwen3-Coder-30B llegando también a EU (Frankfurt). Comprueba el catálogo actual de Bedrock para ver si V4 Pro y Qwen3.8 Max en concreto ya han llegado, ya que las incorporaciones a Bedrock van por detrás de los lanzamientos nuevos.
- La licencia MIT de DeepSeek V4 Pro hace que el autoalojamiento sea sencillo legalmente, aunque necesita infraestructura real. La generación anterior V3/R1 de DeepSeek, construida sobre una arquitectura similar, necesita aproximadamente 16 GPU H100 para ejecutarse a su precisión nativa FP8, según la propia documentación de despliegue de NVIDIA; las configuraciones de 8 GPU solo son posibles con cuantización, a costa de algo de precisión. El tamaño de V4 Pro está en el mismo rango. El checkpoint abierto de Qwen también puede autoalojarse, sujeto a los términos de licencia con umbral de ingresos mencionados arriba.
- La infraestructura principal de DeepSeek y Alibaba está basada en China, aunque ambos ofrecen endpoints de API internacionales (el api.deepseek.com por defecto de DeepSeek, los despliegues de Model Studio en Singapur/EE. UU. de Alibaba). La propia página de precios de Alibaba lista un nivel de "despliegue en EE. UU." dedicado y con precio más alto, lo que implica un enrutamiento regional real en lugar de un único endpoint global. Si la residencia de datos o la latencia añadida hacia infraestructura basada en China es una preocupación de cumplimiento para tu organización, verifícalo directamente con cada proveedor en lugar de asumir un comportamiento por defecto.
Cuál deberías elegir en realidad
Si lo que más importa es el coste por token y el rendimiento en bruto, o tu carga de trabajo se inclina hacia la programación, DeepSeek V4 Pro es la elección clara: más barato en todos los niveles, más del doble de rápido, con licencia MIT si alguna vez quieres autoalojarlo, y competitivo en SciCode. Dado que la tarifa con descuento de DeepSeek ya se aplica por defecto fuera de dos franjas estrechas en días laborables, una carga de trabajo por lotes (procesamiento de documentos, pipelines nocturnos) solo necesita evitar esas horas concretas para funcionar a mitad de precio. Para nuestra audiencia en particular, esa ventaja de precio por token importa más en flujos de investigación de documentos largos y de alto volumen, pasando un gran lote de artículos o transcripciones por un modelo de contexto de 1M, donde la prima del 70% de Qwen se acumula rápido a lo largo de miles de llamadas.
Si necesitas la puntuación más alta en benchmarks amplios de trabajo agéntico y de conocimiento, quieres entrada de imagen nativa en el mismo modelo, y la diferencia de licencia no te afecta porque de todos modos vas a llamar a la API alojada, Qwen3.8 Max va por delante en las cifras que importan para tareas complejas de varios pasos (Terminal-Bench, AA-Briefcase, GDPval-AA). La brecha es real pero no es gratis: pagas aproximadamente un 70% más y obtienes salida a menos de la mitad de velocidad por ello.
Dónde se equivoca la gente
- El antiguo alias qwen-max sigue resolviendo, cuesta una quinta parte del precio del buque insignia, y ejecuta en silencio un modelo más débil solo sin razonamiento, sin precios escalonados. Si copiaste un fragmento de integración de una guía antigua, comprueba la cadena exacta del modelo antes de asumir que estás pagando tarifas de buque insignia.
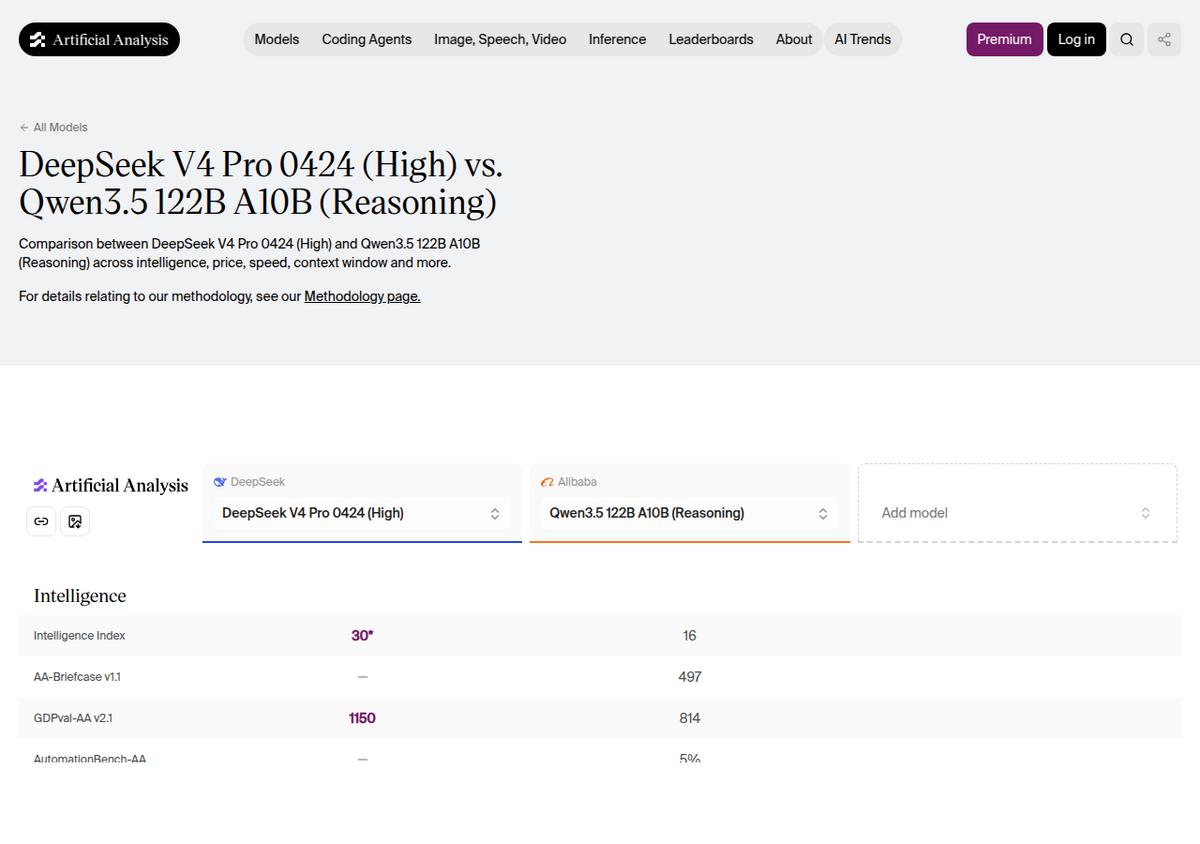
- Un número sorprendente de páginas de comparación que todavía posicionan bien comparan DeepSeek-V4-Pro-0424, la vista previa de abril, con Qwen3.8 Max, el buque insignia actual, lo que sesga la comparación a favor de Qwen tanto en precio como en puntuación de inteligencia, ya que la vista previa nunca fue el producto final. Comprueba que cualquier comparación que leas use la versión de disponibilidad general de agosto, la 0813.
- El mismo emparejamiento de modelos puntúa distinto en las páginas de esfuerzo "High" frente a "Max" de Artificial Analysis. Comprueba siempre qué versión de la comparación estás viendo antes de citar una cifra concreta.
- El checkpoint de pesos abiertos de Qwen3.8 Max no coincide con la API alojada: sin entrada de imagen, sin modo sin razonamiento, y con una licencia distinta a los modelos Apache 2.0 más pequeños de Qwen.
La gente también pregunta
¿Es mejor DeepSeek o Qwen para programar?
Están muy igualados en programación en bruto (SciCode: DeepSeek 51% frente a Qwen 52%), pero DeepSeek V4 Pro queda muy por detrás en uso agéntico de terminal (Terminal-Bench 4.0: 14% frente al 39% de Qwen). Para generación de código sencilla, cualquiera de los dos funciona; para tareas de programación agéntica que implican planificar y ejecutar acciones de varios pasos en una terminal, Qwen3.8 Max puntúa actualmente mucho más alto.
¿Es DeepSeek más barato que Qwen?
Sí, en todos los niveles verificados. La tarifa en horas de mayor demanda de DeepSeek V4 Pro es de 1,32 $/3,96 $ por millón de tokens de entrada/salida frente al precio plano de 2,00 $/6,00 $ de Qwen3.8 Max, y DeepSeek baja a 0,66 $/1,98 $ fuera de esas horas, que es el valor por defecto durante la mayor parte de la semana salvo dos franjas estrechas en días laborables en UTC. El precio de Qwen nunca cambia según la hora del día.
¿Es DeepSeek V4 Pro de código abierto?
Sus pesos se reportan con licencia MIT, la licencia estándar de DeepSeek para lanzamientos anteriores como V3 y R1, que permite uso comercial y autoalojamiento sin ninguna restricción de ingresos. No pudimos verificar de forma independiente el archivo de licencia exacto del propio repositorio de DeepSeek, así que compruébalo directamente antes de depender de él para un despliegue de producción.
¿Qwen3.8 Max es de pesos abiertos?
Parcialmente, y con matices que se le escapan a la mayoría de la cobertura. El modelo de la API alojada es propietario. Alibaba publicó por separado un checkpoint de pesos abiertos detrás de él en agosto de 2026, pero bajo una licencia personalizada "Qwen3.8-Max license", no la licencia permisiva Apache 2.0 que usan los modelos más pequeños de Qwen, reportadamente con un umbral de ingresos comerciales para despliegues grandes.
¿Cuál tiene la ventana de contexto más larga, DeepSeek o Qwen?
Están prácticamente igualados: DeepSeek V4 Pro indica una ventana de contexto de 1.000.000 de tokens, Qwen3.8 Max indica 984.000, ambas según el comparativo actual de Artificial Analysis. Ambas están ampliadas desde ventanas nativas menores, no son así de grandes de forma nativa.
¿Puedo autoalojar DeepSeek o Qwen en lugar de usar la API?
Ambos son técnicamente posibles. La licencia MIT de DeepSeek V4 Pro hace que el autoalojamiento sea sencillo legalmente, aunque el modelo de 1,6 billones de parámetros necesita infraestructura seria de múltiples GPU. El checkpoint de pesos abiertos de Qwen también puede autoalojarse, pero merece la pena comprobar el umbral de ingresos comerciales de su licencia personalizada frente a la escala de tu organización antes de comprometerte.