Qwen3.8 Max erzielt auf Artificial Analysis' Intelligence Index einen höheren Wert (45 gegenüber 36), kostet aber rund 70 % mehr und erzeugt Output mit weniger als der halben Geschwindigkeit von DeepSeek (42 statt 99 Token pro Sekunde), laut Artificial Analysis' aktuellem direkten Vergleich, heute geprüft.
Die Gewichte von DeepSeek V4 Pro sind MIT-lizenziert und herunterladbar. Qwen3.8 Max' gehostete API ist proprietär, und selbst der separat veröffentlichte Open-Weight-Checkpoint dahinter trägt eine benutzerdefinierte, nicht Apache-basierte Lizenz mit einer Umsatz-Schwelle für kommerzielle Nutzung, nicht die freizügige Lizenz, für die Qwens kleinere Modelle bekannt sind.
Bei agentischem Coding und Terminal-Nutzung ist DeepSeek konkurrenzfähig oder vorn: Es liegt bei SciCode knapp vor Qwen und verliert deutlich bei Terminal-Bench 4.0 (14 % gegenüber 39 %). Qwen führt bei allgemeinem Wissen und agentischen Wissensarbeits-Benchmarks mit deutlichem Abstand.
DeepSeek hat einen eingebauten Nebenzeit-Rabatt, rund 50 % günstiger bei Input und Output, der standardmäßig für den größten Teil der Woche gilt; der volle Preis greift nur während zwei schmaler wochentäglicher UTC-Zeitfenster. Qwens Preise sind rund um die Uhr gleich.
Die Flaggschiffe, Stand Oktober 2026
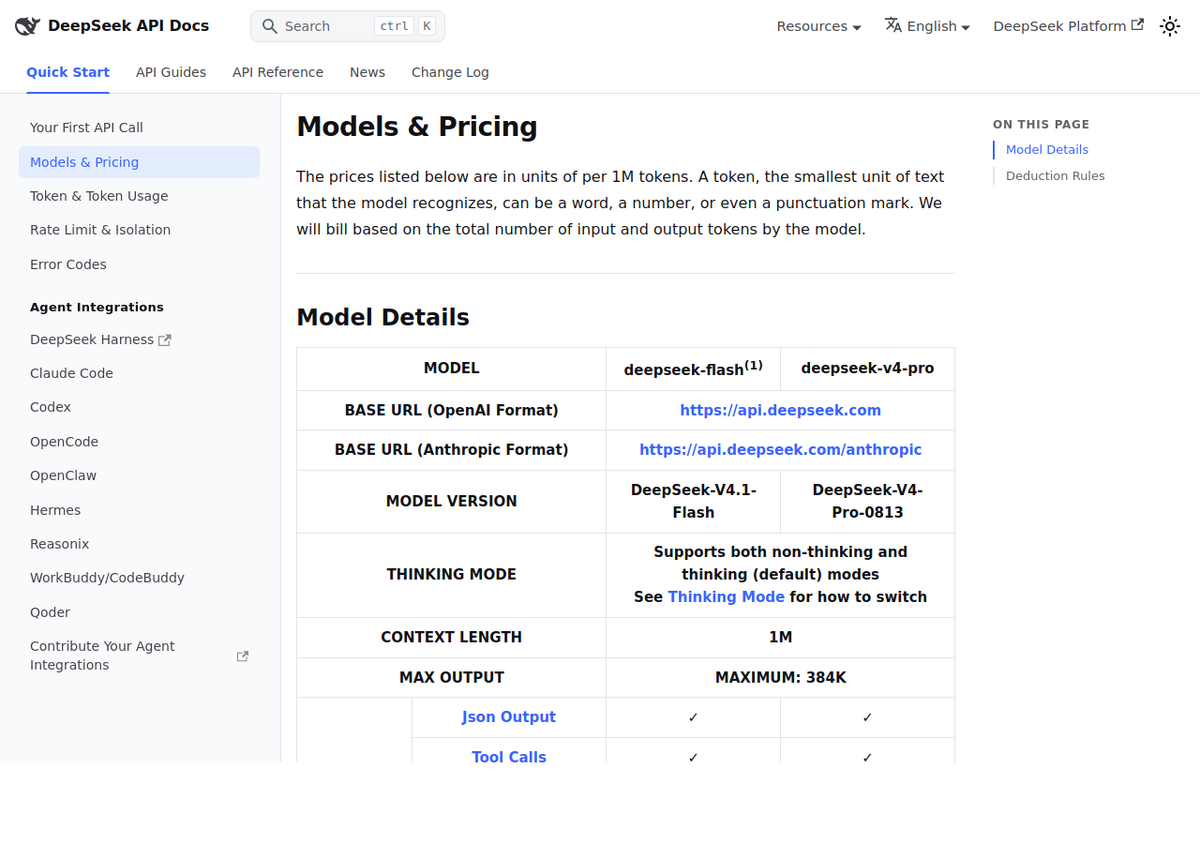
Beide Unternehmen vergeben Versionsnummern, die sich oft genug ändern, um Suchergebnisse zu verwirren, daher lohnt es sich, genau zu benennen, welchen Build dieser Vergleich abdeckt. DeepSeek-V4-Pro-0813 ist die General-Availability-Version, die DeepSeeks eigene API-Doku heute führt, laut Versionssuffix datiert auf den 13. August 2026; sie folgte auf einen Preview-Build vom April 2026, den viele ältere Vergleichsseiten (darunter einige, die noch ranken) tatsächlich stattdessen messen. Laut NVIDIAs NIM-Modellkarte ist es ein Mixture-of-Experts-Modell mit 1,6 Billionen Gesamtparametern und 49 Milliarden aktiven Parametern pro Token, 384 gerouteten Experten mit 6 ausgewählten pro Token, einem Kontextfenster von 1 Million Token und einem maximalen Output von 384.000 Token. Eine Sekundärquelle nennt für die GA-Karte 1,7 statt 1,6 Billionen Gesamtparameter; diese Abweichung konnten wir nicht gegen DeepSeeks eigenen technischen Bericht bestätigen und weisen sie hier aus, statt eine Zahl zu wählen, die präziser klingt, als es die Belege zulassen.
Qwen3.8-Max-0902 ist Alibabas aktuelles Flaggschiff, ein September-2026-Refresh der Qwen3.8-Max-Linie, die erstmals am 3. August 2026 startete. Es ist ein Sparse-Mixture-of-Experts-Modell mit laut Berichten 2,4 Billionen Gesamtparametern und rund 95 Milliarden aktiven Parametern pro Token (512 Experten, 10 ausgewählt pro Token, laut mehreren unabhängigen Trackern; Alibabas eigene Seiten veröffentlichen die Expertenzahl nicht direkt). Artificial Analysis gibt das Kontextfenster mit 984.000 Token an, praktisch dieselbe 1-Millionen-Token-Klasse wie DeepSeek, erweitert von einem kleineren nativen Fenster. Anders als DeepSeek akzeptiert Qwen3.8 Max über die gehostete API auch Bild-Input; DeepSeek V4 Pro ist textbasiert.
Preise: offizielle Zahlen, keine Aggregator-Schätzungen
DeepSeek veröffentlicht seine Preise direkt in den eigenen API-Dokumenten, gestaffelt danach, ob man außerhalb oder innerhalb der UTC-Stoßzeiten anfragt. Alibaba veröffentlicht die Qwen3.8-Max-Preise auf der eigenen Model-Studio-Preisseite, in CNY, gestaffelt nach Deployment-Region: Die China-/Global-Default-Preise sind merklich günstiger als das Singapur-/US-Deployment, das die meisten Entwickler außerhalb Chinas tatsächlich nutzen.
Per 1M tokens              DeepSeek V4 Pro-0813      Qwen3.8 Max-0902
-----------------------------------------------------------------------
Input (peak hours)          $1.32                      $2.00
Input (off-peak, DeepSeek   $0.66                      n/a (flat rate)
  only, see note below)
Output (peak hours)         $3.96                      $6.00
Output (off-peak)           $1.98                      n/a
Cache hit                   $0.044                     $0.25
Blended (AA's 7:2:1 ratio)  $0.69                       $1.18

DeepSeek peak window (full price): 01:00-04:00 and 06:00-10:00 UTC,
Monday through Friday, excluding Chinese public holidays. Every other
hour, including weekends, bills at the cheaper off-peak rate. Source:
DeepSeek's own API docs, api-docs.deepseek.com/quick_start/pricing.
Qwen figures are the Singapore/US international deployment tier, converted
from Alibaba's own CNY 14.988 / CNY 44.965 per-million rate (Alibaba's
China/global-default tier is roughly 20% cheaper at CNY 12 / CNY 36).
Source: help.aliyun.com/en/model-studio/model-pricing, checked 14 Oct 2026.
Es gibt auf beiden Seiten auch eine Budget-Stufe, die man kennen sollte, falls der Flaggschiff-Preis mehr ist, als man braucht: DeepSeeks deepseek-flash (DeepSeek-V4.1-Flash) kostet 0,15 $/0,60 $ zu Stoßzeiten und 0,075 $/0,30 $ in Nebenzeiten pro Million Input-/Output-Token, rund ein Neuntel der Flaggschiff-Kosten, bei demselben 1-Mio.-Kontextfenster. Alibabas Legacy-Alias qwen-max ist auf seiner China-/Global-Default-Stufe mit CNY 2,4/9,6 pro Million Token ähnlich günstig, ein Fünftel von Qwen3.8 Max' eigener China-Stufe mit CNY 12/36, aber es ist ein reines Non-Thinking-Modell ohne gestaffelte Preise nach Kontextlänge, ein Modellstring, den man leicht versehentlich erwischt, wenn man eine ältere Integrationsanleitung kopiert.
Benchmarks: Wer tatsächlich wo gewinnt
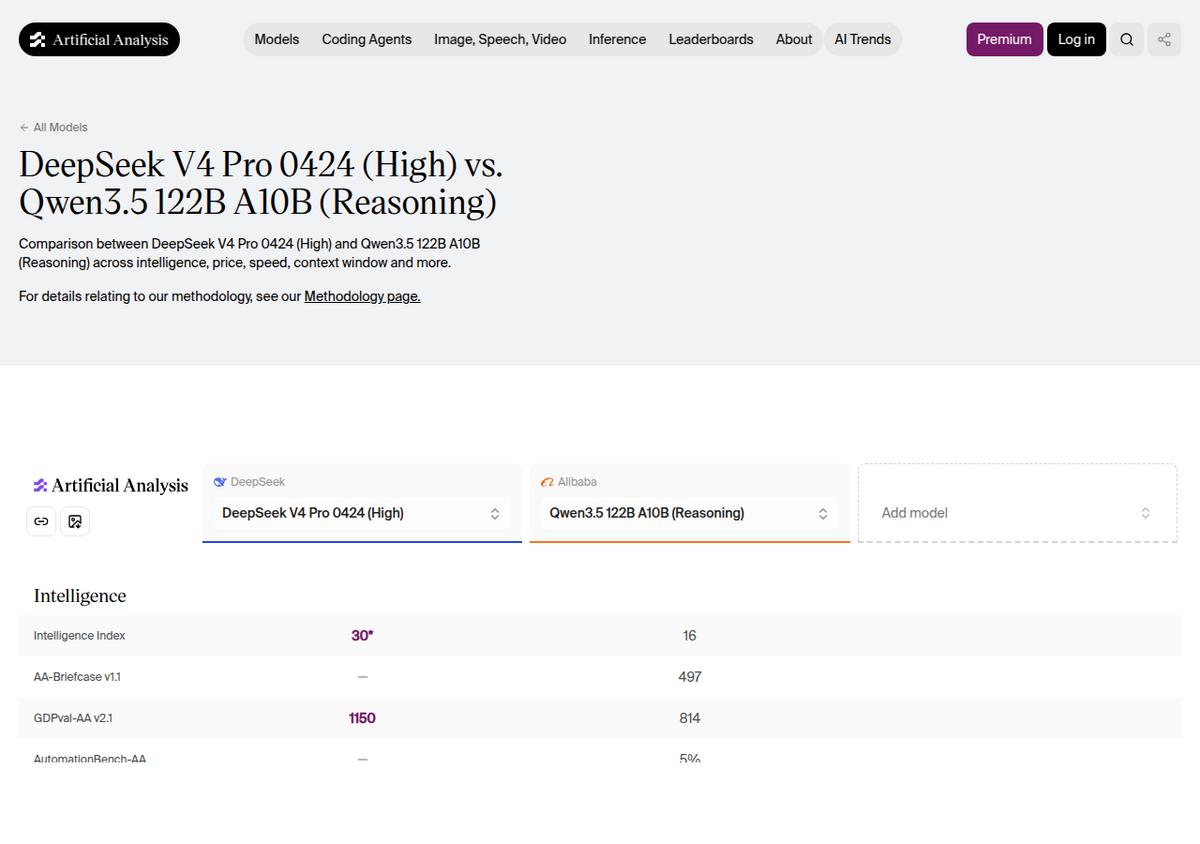
Artificial Analysis führt einen direkten Vergleich zwischen den aktuellen Flaggschiffen durch, beide auf maximalen Reasoning-Aufwand gesetzt, bewertet auf seinem Intelligence Index v4.3.2. Qwen3.8 Max führt bei der Gesamtintelligenz und bei den meisten agentischen Wissensarbeits-Aufgaben; DeepSeek V4 Pro liegt bei coding-nahen Benchmarks nah dran oder vorn und ist überall drastisch günstiger und schneller.
Benchmark (max effort)                 Qwen3.8 Max-0902    DeepSeek V4 Pro-0813
---------------------------------------------------------------------------
Intelligence Index (v4.3.2)             45                   36
Terminal-Bench 4.0 (agentic terminal)   39%                  14%
SciCode (coding)                        52%                  51%
AA-Briefcase v1.1 (agentic knowledge)   1617                 1257
GDPval-AA v2.1 (agentic real work)      1667                 1449
AutomationBench-AA (agentic SaaS)       56%                  57%
Humanity's Last Exam                    43%                  41%
GDP.pdf                                 23%                  11%
CritPt (physics reasoning)              18%                  18%
AA-Omniscience                          12                   1
AA-LCR v1.1 (long-context reasoning)    80%                  80%
Output speed (tokens/sec)               42                   99

Source: artificialanalysis.ai/models/comparisons/deepseek-v4-pro-vs-qwen3-8-max,
checked 14 Oct 2026. Note: Artificial Analysis publishes several versions of
this comparison at different DeepSeek reasoning-effort settings (High vs.
Max); scores shift by several points between them, so if you see different
numbers elsewhere, check which effort setting the page is showing.
Das Muster, das sich durch beide Tabellen zieht: Qwen gewinnt bei Aufgaben, die breites Wissen und mehrstufige agentische Planung belohnen (Terminal-Bench, AA-Briefcase, GDPval-AA, AA-Omniscience), während beide bei reinem Coding (SciCode) und Long-Context-Retrieval (AA-LCR, beide bei 80 %) praktisch gleichauf liegen. Keines der beiden Modelle veröffentlicht in diesem Vergleich einen mathematikspezifischen Benchmark. Wenn die eigene Arbeitslast näher an „Code schreiben und debuggen" liegt als an „eine mehrstufige agentische Aufgabe planen und ausführen", zählt die Benchmark-Lücke deutlich weniger als der 70-prozentige Preisunterschied.
Lizenzierung: die Lücke, die die meisten Vergleiche falsch darstellen
DeepSeek V4 Pros Gewichte werden als MIT-lizenziert angegeben, passend zu DeepSeeks früheren V3- und R1-Veröffentlichungen, laut seinem NVIDIA-NIM-Eintrag und unabhängigen Modell-Trackern (wir konnten die Lizenzdatei nicht direkt aus DeepSeeks eigenem Hugging-Face-Repo abrufen, um den genauen Wortlaut zu bestätigen, daher sollte man das als gut belegt, aber nicht primärquellen-verifiziert einordnen). MIT ist so freizügig, wie Lizenzierung nur sein kann: kommerzielle Nutzung, Veränderung und Weiterverbreitung ohne Umsatzobergrenze.
Bei Qwen3.8 Max sieht es anders aus, und genau hier übertreibt viel Berichterstattung über „Qwen ist Open Source". Das gehostete API-Modell ist schlicht proprietär, genau wie Gemini oder GPT. Alibaba hat separat einen Open-Weight-Checkpoint dahinter veröffentlicht, laut Berichten Qwen3.8-2.4T-A95B genannt, etwa am 12. August 2026 auf Hugging Face, nur Text und auf den Thinking-Modus beschränkt (der Bild-Input und der Non-Thinking-Modus, die die gehostete API bietet, sind nicht in der offenen Veröffentlichung enthalten). Dieser Checkpoint läuft aber unter einer benutzerdefinierten „Qwen3.8-Max-Lizenz", nicht Apache 2.0, und mehrere Tracker berichten, dass sie eine Ausnahme für kommerzielle Nutzung enthält, die eine separate Vereinbarung erfordert, sobald der nachlaufende 12-Monats-Umsatz eines einsetzenden Unternehmens 50 Millionen Dollar in bestimmten KI-Dienstleistungskategorien übersteigt. Das ist ein deutlich anderer Deal als bei Qwens kleinerem Dense-Modell Qwen3.8-27B, das Apache 2.0 ist, ohne Umsatzschwelle. Wir konnten den genauen Lizenztext nicht abrufen, um seine Bedingungen wörtlich zu zitieren, daher sollte man die aktuelle Lizenzdatei direkt auf Hugging Face prüfen, bevor man eine Produktionsabhängigkeit darauf aufbaut. Die praktische Erkenntnis: „Qwen ist Open-Weight" stimmt für Qwens kleinere Modelle und ist falsch, oder zumindest stark einzuschränken, für sein tatsächliches 2,4-Billionen-Parameter-Flaggschiff.
Wo man sie tatsächlich betreiben kann
- Beide Anbieter bieten direkten API-Zugang: api.deepseek.com (OpenAI- und Anthropic-kompatible Endpunkte) und Alibaba Cloud Model Studio für Qwen, abgerechnet wie oben gezeigt.
- AWS hat DeepSeek-V3.1 und mehrere Qwen3-Modelle 2025 als voll verwaltete Angebote zu Bedrock hinzugefügt (laut Amazons eigener Ankündigung): DeepSeek-V3.1 und Qwen3-Coder-480B in US East (Ohio) und AP (Jakarta), wobei Qwen3-32B, Qwen3-235B und Qwen3-Coder-30B auch EU (Frankfurt) erreichen. Prüfe Bedrocks aktuellen Katalog, ob konkret V4 Pro und Qwen3.8 Max dort angekommen sind, da Bedrock-Ergänzungen neuen Releases hinterherhinken.
- DeepSeek V4 Pros MIT-Lizenz macht Self-Hosting rechtlich unkompliziert, auch wenn es echte Infrastruktur braucht. DeepSeeks vorherige V3/R1-Generation, auf ähnlicher Architektur aufgebaut, braucht laut NVIDIAs eigener Deployment-Dokumentation rund 16 H100-GPUs, um in nativer FP8-Präzision zu laufen; 8-GPU-Setups sind nur mit Quantisierung möglich, die etwas Genauigkeit kostet. V4 Pros Bedarf liegt in derselben Größenordnung. Der offene Qwen-Checkpoint lässt sich ebenfalls selbst hosten, vorbehaltlich der oben genannten Umsatzschwellen-Lizenzbedingungen.
- DeepSeeks und Alibabas primäre Infrastruktur liegt in China, auch wenn beide internationale API-Endpunkte anbieten (DeepSeeks Standard api.deepseek.com, Alibabas Singapur-/US-Model-Studio-Deployments). Alibabas eigene Preisseite listet eine dedizierte, teurere „US-Deployment"-Stufe, was echtes regionales Routing statt eines einzigen globalen Endpunkts nahelegt. Falls Datenresidenz oder zusätzliche Latenz zu chinabasierter Infrastruktur für die eigene Organisation ein Compliance-Thema ist, sollte man das direkt mit dem jeweiligen Anbieter klären statt einen Standard anzunehmen.
Welches sollte man tatsächlich wählen
Wenn Kosten pro Token und reiner Durchsatz am wichtigsten sind, oder die eigene Arbeitslast eher Richtung Coding geht, ist DeepSeek V4 Pro die klare Wahl: günstiger auf jeder Stufe, mehr als doppelt so schnell, MIT-lizenziert, falls man je selbst hosten möchte, und konkurrenzfähig bei SciCode. Da DeepSeeks vergünstigter Tarif standardmäßig außerhalb von zwei schmalen wochentäglichen Zeitfenstern gilt, muss ein Batch-Workload (Dokumentenverarbeitung, nächtliche Pipelines) nur diese bestimmten Stunden vermeiden, um zum halben Preis zu laufen. Für unser Publikum speziell zählt dieser Preis-pro-Token-Vorteil am meisten bei Recherche-Workflows mit langen Dokumenten und hohem Volumen, wenn ein großer Batch von Papers oder Transkripten durch ein Modell mit 1-Mio.-Kontext läuft, wo sich Qwens 70-Prozent-Aufschlag über Tausende von Aufrufen schnell summiert.
Wenn man den höchsten Wert bei breiten agentischen und Wissensarbeits-Benchmarks braucht, nativen Bild-Input im selben Modell will, und der Lizenzunterschied keine Rolle spielt, weil man ohnehin die gehostete API aufruft, liegt Qwen3.8 Max bei den Zahlen vorn, die für komplexe mehrstufige Aufgaben zählen (Terminal-Bench, AA-Briefcase, GDPval-AA). Der Abstand ist real, aber nicht kostenlos: Man zahlt rund 70 % mehr und bekommt dafür Output mit weniger als der halben Geschwindigkeit.
Worüber Leute stolpern
- Der alte Alias qwen-max funktioniert weiterhin, kostet ein Fünftel des Flaggschiff-Preises und läuft im Stillen auf einem schwächeren, reinen Non-Thinking-Modell ohne gestaffelte Preise. Wer ein Integrationssnippet aus einer älteren Anleitung kopiert hat, sollte den genauen Modellstring prüfen, bevor er annimmt, Flaggschiff-Preise zu zahlen.
- Überraschend viele noch rankende Vergleichsseiten benchmarken DeepSeek-V4-Pro-0424, die April-Preview, gegen Qwen3.8 Max, das aktuelle Flaggschiff, was den Vergleich sowohl bei Preis als auch beim Intelligenz-Wert zu Qwens Gunsten verzerrt, da der Preview-Build nie das ausgelieferte Produkt war. Prüfe bei jedem gelesenen Vergleich, ob er die August-GA-Version 0813 verwendet.
- Dieselbe Modellpaarung erzielt auf Artificial Analysis' „High"- und „Max"-Aufwandsseiten unterschiedliche Werte. Immer prüfen, welche Version des Vergleichs man gerade vor sich hat, bevor man eine bestimmte Zahl zitiert.
- Qwen3.8 Max' Open-Weight-Checkpoint entspricht nicht der gehosteten API: kein Bild-Input, kein Non-Thinking-Modus, und eine andere Lizenz als Qwens kleinere Apache-2.0-Modelle.
Häufig gestellte Fragen
Ist DeepSeek oder Qwen besser für Coding?
Bei reinem Coding liegen sie nah beieinander (SciCode: DeepSeek 51 % gegenüber Qwen 52 %), aber DeepSeek V4 Pro liegt bei agentischer Terminal-Nutzung weit zurück (Terminal-Bench 4.0: 14 % gegenüber Qwens 39 %). Für einfache Code-Generierung funktionieren beide; für agentische Coding-Aufgaben, die das Planen und Ausführen mehrstufiger Terminal-Aktionen umfassen, erzielt Qwen3.8 Max derzeit deutlich höhere Werte.
Ist DeepSeek günstiger als Qwen?
Ja, auf jeder geprüften Stufe. DeepSeek V4 Pros Stoßzeiten-Preis liegt bei 1,32 $/3,96 $ pro Million Input-/Output-Token gegenüber Qwen3.8 Max' pauschalen 2,00 $/6,00 $, und DeepSeek sinkt in Nebenzeiten auf 0,66 $/1,98 $, was standardmäßig für den größten Teil der Woche gilt, außer zwei schmalen wochentäglichen UTC-Zeitfenstern. Qwens Preise ändern sich nie nach Tageszeit.
Ist DeepSeek V4 Pro Open Source?
Seine Gewichte werden als MIT-lizenziert angegeben, DeepSeeks Standardlizenz für frühere Releases wie V3 und R1, die kommerzielle Nutzung und Self-Hosting ohne Umsatzbeschränkung erlaubt. Wir konnten die genaue Lizenzdatei aus DeepSeeks eigenem Repository nicht unabhängig verifizieren, daher sollte man sie direkt prüfen, bevor man sich für ein Produktions-Deployment darauf verlässt.
Ist Qwen3.8 Max Open Weight?
Teilweise, und mit Einschränkungen, die die meiste Berichterstattung übersieht. Das gehostete API-Modell ist proprietär. Alibaba hat im August 2026 separat einen Open-Weight-Checkpoint dahinter veröffentlicht, aber unter einer benutzerdefinierten „Qwen3.8-Max-Lizenz", nicht der freizügigen Apache-2.0-Lizenz, die Qwens kleinere Modelle verwenden, laut Berichten einschließlich einer Umsatzschwelle für große Deployments.
Wer hat das längere Kontextfenster, DeepSeek oder Qwen?
Sie liegen praktisch gleichauf: DeepSeek V4 Pro gibt ein Kontextfenster von 1.000.000 Token an, Qwen3.8 Max 984.000, beide laut Artificial Analysis' aktuellem Vergleich. Beide sind von kleineren nativen Fenstern aus erweitert, nicht nativ so groß.
Kann ich DeepSeek oder Qwen selbst hosten statt die API zu nutzen?
Beides ist technisch möglich. DeepSeek V4 Pros MIT-Lizenz macht Self-Hosting rechtlich unkompliziert, auch wenn das 1,6-Billionen-Parameter-Modell ernsthafte Multi-GPU-Infrastruktur braucht. Qwens Open-Weight-Checkpoint lässt sich ebenfalls selbst hosten, aber die Umsatzschwelle seiner benutzerdefinierten Lizenz sollte man vor der Entscheidung gegen die eigene Unternehmensgröße prüfen.