Beam es un modelo disperso de mezcla de expertos con 501.000 millones de parámetros (23.000 millones activos por token) de Reflection AI, anunciado el 5 de octubre de 2026 y lanzado como pesos abiertos bajo licencia Apache 2.0 el 16 de octubre. Los pesos están disponibles en Hugging Face en BF16, FP8 y NVFP4, con una API propia en beta pública y más de 40 socios de lanzamiento, entre ellos AWS, Google Cloud, Oracle, Cloudflare y OpenRouter.
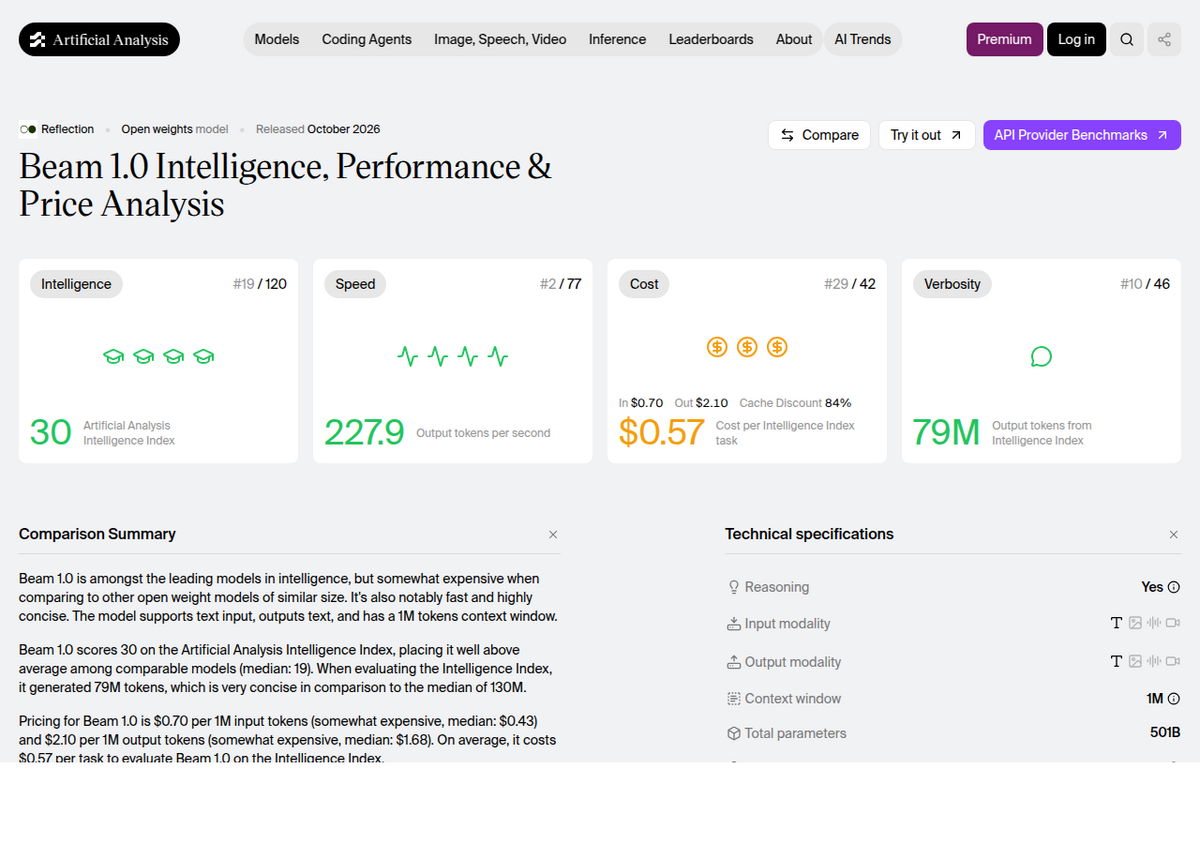
De forma independiente, puntúa 30 en el Intelligence Index de Artificial Analysis (mediana para modelos comparables: 19), en el puesto 19 de 120 modelos rastreados en el momento de escribir esto. Es rápido (227,9 tokens de salida por segundo, 2º de 77 modelos medidos) y relativamente barato de ejecutar por tarea, pero no es el modelo de pesos abiertos más fuerte disponible: el Kimi K3 de Moonshot le gana en la mayoría de benchmarks de razonamiento y agénticos, y la propia tabla publicada por Reflection lo admite.
Necesita hardware serio. En BF16, solo los pesos ocupan aproximadamente 1TB; incluso en FP8 necesitas algo como un único nodo 8xH200. No hay forma realista de ejecutarlo en un portátil o en una sola GPU de consumo.
No tiene relación con la polémica de "Reflection 70B" de 2024, en la que el modelo "70B" alojado de otra empresa resultó estar redirigiendo en secreto las peticiones a Claude. Reflection AI (2024, fundada por Misha Laskin e Ioannis Antonoglou) es una empresa sin relación alguna, una confusión que aparece lo bastante a menudo en foros de desarrolladores como para merecer decirlo claramente.
Qué es Beam en realidad
Beam es un modelo disperso de mezcla de expertos: 501.000 millones de parámetros totales, pero solo 23.000 millones se activan para un token dado, repartidos en 52 capas con atención local y global intercalada y balanceo de carga entre expertos sin pérdida auxiliar. Es exclusivamente de texto, tanto en la entrada como en la salida: no genera imágenes, y solo puede razonar sobre contenido visual si otra herramienta lo convierte primero en texto. El propio anuncio de Reflection lo describe como orientado directamente a codificación, razonamiento y trabajo agéntico, no al chat general.
Los datos de preentrenamiento son la parte a la que Reflection dedica más palabras. La empresa dice que partió del rastreo bruto habitual de internet y descartó alrededor del 95% mediante curación, quedándose con unos 1,8 billones de tokens de lo que llama material genuinamente de alta calidad que los filtros convencionales habrían pasado por alto, integrados en una ejecución total de preentrenamiento de 23,8 billones de tokens. La ventana de contexto es de 1 millón de tokens, pero esa cifra se alcanza mediante un paso de extensión a mitad del entrenamiento; la fase de aprendizaje por refuerzo que sigue está limitada a 256.000 tokens, una distinción que vale la pena conocer si estás evaluando Beam específicamente para tareas agénticas de contexto muy largo y no solo para documentos individuales largos.
La ejecución de entrenamiento, en cifras que la mayoría de anuncios de modelos no publican
Reflection es inusualmente específica sobre cómo se construyó Beam, y las dos fases de entrenamiento usaron hardware distinto. El preentrenamiento se ejecutó en 6.144 GPUs Nvidia GB300 NVL72 durante menos de cuatro semanas, alcanzando un 92,3% de goodput (la proporción del tiempo de GPU que realmente produce progreso útil de entrenamiento) hacia el final de la ejecución, con 9 retrocesos semiautomáticos provocados por picos de gradiente o sospecha de corrupción silenciosa de datos. El aprendizaje por refuerzo se ejecutó después, por separado, en 10.500 GPUs GB300 durante cuatro semanas, generando más de 100 millones de rollouts, de los cuales unos 80 millones se dirigieron específicamente a un subcomponente "experto en razonamiento". En su punto máximo, la ejecución de RL sostuvo una media de unos 110.000 rollouts concurrentes y hasta 170.000 sandboxes concurrentes, 1.300 millones de invocaciones de sandbox en total frente a aproximadamente 1 millón de entornos de RL mayoritariamente sintéticos. Según se informa, las actualizaciones de pesos llegaron a la flota de inferencia en vivo en una mediana de unos 12 segundos, y la ejecución absorbió 71 incidentes de inferencia sin detener el entrenamiento, recuperándose en una mediana de 8 minutos cada vez.
Esas dos cifras de GPUs, 6.144 para el preentrenamiento y 10.500 para el RL, aparecen en distintos artículos de terceros como si se contradijeran entre sí. No es así: una es el clúster de preentrenamiento, la otra es el clúster de aprendizaje por refuerzo mucho más grande que se ejecutó después, y mezclarlas es un error que conviene vigilar si estás contrastando otra cobertura de este lanzamiento.
Anunciado el 5 de octubre, lanzado de verdad el 16 de octubre
Este es el detalle en el que más se queda desactualizada la cobertura existente sobre Beam, porque la mayoría se escribió en ese hueco. El anuncio del 5 de octubre de Reflection abrió un acceso anticipado solo mediante lista de espera, y la empresa decía que los pesos, un informe técnico y herramientas para desarrolladores llegarían "en las próximas semanas" mientras el modelo terminaba lo que describía como comprobaciones de seguridad finales. Once días después, Reflection publicó una segunda entrada, "Beam is now available", fechada el 16 de octubre de 2026, confirmando el lanzamiento completo: pesos abiertos en Hugging Face (formatos BF16, FP8 y NVFP4, más un modelo auxiliar de decodificación especulativa aparte), una licencia Apache 2.0 confirmada, una API propia en platform.reflection.ai en beta pública descrita como "gratis para empezar", y un informe técnico de seguridad que cubre un enfoque de destilación on-policy con múltiples modelos maestros para el entrenamiento de seguridad.
El lanzamiento también llegó con más de 40 socios de lanzamiento ya conectados: plataformas en la nube (AWS, Google Cloud, Microsoft Foundry, Oracle, Cloudflare, CoreWeave, Databricks), mercados de inferencia (Together AI, OpenRouter, Baseten, Fireworks, Nebius, Modal), los propios microservicios NIM de Nvidia, herramientas de inferencia local (Ollama, LM Studio), socios de despliegue on-prem y soberano/air-gapped (Dell, HPE), y soporte desde el primer día en los stacks de servicio de código abierto que de verdad usan los desarrolladores (Transformers, vLLM, SGLang, Unsloth, Axolotl). Vercel lo ofreció gratis en su AI Gateway durante la ventana de lanzamiento. Eso es un esfuerzo de distribución genuinamente amplio para un anuncio de empresa de hace dos semanas, y es la razón de más peso para tratar el lanzamiento del 16 de octubre, y no el adelanto del 5 de octubre, como la fecha de lanzamiento real cuando cites este modelo en otro sitio.
Cómo puntúa, de forma independiente y según la propia tabla de Reflection
Artificial Analysis, que somete a todos los modelos al mismo Intelligence Index estandarizado en lugar de tomar la puntuación autoinformada de un proveedor, sitúa a Beam en 30, frente a una mediana de categoría de 19, lo que lo coloca en el puesto 19 de 120 modelos rastreados. Es un resultado sólido, por encima de la mediana. También es notablemente rápido (227,9 tokens de salida por segundo, 2º de 77 modelos medidos) y relativamente conciso (79 millones de tokens para completar el Index entero, frente a una mediana de 130 millones), lo que mantiene su coste por tarea en 0,57 $ a pesar de un precio por token (0,70 $ de entrada, 2,10 $ de salida por millón de tokens) que la propia Artificial Analysis califica de "algo caro" frente al resto del sector.
Benchmark (Reflection's own table,      Beam    GLM-5.2   Kimi K3   Qwen 3.8   DeepSeek
updated 8 Oct 2026)                                                    Max       V4.1 Flash
-----------------------------------------------------------------------------------------
SWE-Bench Pro v1                        65.5     62.1       NR       67.7        NR
Terminal-Bench v2.1                     80.1     81.0      88.3      86.6       90.6
DeepSWE v1.1                            44.4     44.0      68.0      51.0       74.2
GPQA Diamond                            90.5     91.2      93.5      92.6       90.9
tau3 banking (agentic tool use)         38.0     37.1      37.1      55.2         NR
BrowseComp                              77.4       NR      91.2        NR         NR
HLE, no tools                           36.2     40.5      46.9      43.6       39.1

Figures are Reflection AI's own published comparison table. NR means
Reflection didn't report that model on that benchmark.
SWE-bench Verified (Beam: 80.9) is omitted here because Reflection's table
only compares it against two other models on that specific benchmark, not
this set.
Lee esa tabla de la forma en que la plantea la propia Reflection, porque la empresa es sincera sobre dónde pierde Beam. Su afirmación principal es que Beam rinde aproximadamente a la par que GLM-5.2 de Z.ai en razonamiento avanzado con tres o cuatro veces menos cómputo de inferencia, una cifra que Reflection etiqueta explícitamente como una estimación (calculada como 2 × parámetros activos × tokens generados de media, usando recuentos de tokens de terceros), no como un coste en dólares medido. La comparación también es contra GLM-5.2, no contra el GLM-5.3 más nuevo de Z.ai, que puntúa más alto que Beam en casi todas las filas de la tabla anterior. Y Reflection afirma directamente, sin matizarlo, que el Kimi K3 de Moonshot lidera en capacidad bruta: Kimi K3 es un modelo nativamente multimodal de 2,8 billones de parámetros con un Intelligence Index de Artificial Analysis de alrededor de 57, aproximadamente al nivel de Claude Opus 5.5 y muy por delante del 30 de Beam. La propuesta de Beam es la eficiencia y la procedencia estadounidense, no ganar en comparación directa de capacidad.
Una cifra que vale la pena señalar antes de confiar en Beam para algo factual: en el benchmark AA-Omniscience de Artificial Analysis, que mide con qué frecuencia un modelo afirma algo falso con confianza, la tasa de alucinación de Beam ronda el 47%, frente a una tasa de respuesta correcta de alrededor del 33% en el mismo test. Esa es una proporción notablemente peor de lo que querrías para investigación o trabajo con muchas citas, y es un buen argumento para combinar Beam con recuperación o fundamentación en fuentes (el tipo de cosa que Gemini Notebook hace de forma nativa) en vez de confiar en sus afirmaciones factuales sin apoyo.
¿Es Beam de verdad el mejor modelo de pesos abiertos "occidental"? No del todo
Varios artículos de la semana de lanzamiento presentaron a Beam como la respuesta estadounidense líder a los laboratorios chinos de pesos abiertos, sin comprobar qué más se había lanzado en la misma ventana. En el propio Intelligence Index de Artificial Analysis, Muse Spark Open de Meta, un modelo de pesos abiertos de 816.000 millones de parámetros (42.000 millones activos) lanzado bajo la propia Muse Model License de Meta, puntúa 39, por delante del 30 de Beam. Eso convierte a Beam en el segundo modelo de pesos abiertos de origen estadounidense según esta medida, no en el primero. (Muse Spark Open es un modelo distinto de Muse Wonder de Meta, un modelo frontera cerrado que Meta lanzó el mismo mes; los dos son fáciles de confundir por compartir la marca "Muse", pero uno es de pesos abiertos y el otro no.) Es una corrección pequeña, pero es el tipo de cosa que vale la pena tener clara si estás elegiendo un modelo específicamente por su origen y no por sus puntuaciones de benchmark.
¿Puedes ejecutarlo tú mismo de verdad?
No en un portátil, y no en una sola GPU de consumo. Como Beam es un modelo de mezcla de expertos, solo 23.000 millones de sus 501.000 millones de parámetros se activan por token, lo que mantiene bajo el cómputo de inferencia, pero los 501.000 millones de parámetros igualmente tienen que estar en memoria, sin importar qué expertos estén activos para una petición concreta. A precisión BF16 completa, eso son aproximadamente 1TB de memoria de pesos; FP8 o INT8 lo reduce a entre unos 500 y 600 GB; la cuantización más agresiva, NVFP4/INT4, te deja en torno a 250-360 GB. El mínimo práctico para autoalojarlo es un único nodo 8xH200 (141 GB por GPU) ejecutando FP8, o dos nodos 8xH100 (80 GB) repartidos con paralelismo de tensores y de pipeline. Este es un modelo de nivel centro de datos, no para aficionados, algo que conviene saber antes de buscar una forma de ejecutarlo en casa.
Si solo quieres usarlo en vez de alojarlo, el precio varía notablemente según el proveedor: OpenRouter lo lista en torno a 0,25 $ de entrada / 1,00 $ de salida por millón de tokens, mientras que la mediana medida por la propia Artificial Analysis entre proveedores está más cerca de 0,70 $/2,10 $. Trata cualquier cifra concreta de aquí como una foto fija y no como un precio permanente; comprueba la tarifa en vivo del proveedor que de verdad estés usando, porque Beam se lanzó con más de 40 socios de alojamiento y no todos le ponen el mismo precio.
Lo que de verdad dicen los desarrolladores
El hilo de Hacker News sobre el anuncio original de Beam (556 puntos, 173 comentarios) es una lectura útil del ambiente, y se desarrolló casi por completo antes del lanzamiento del 16 de octubre. La crítica sustancial más votada comparaba a Beam directamente con el V4.1 Flash de DeepSeek: un comentarista escribió que Beam "parece ser más grande que DeepSeek v4.1 Flash, más caro de ejecutar, y peor en todas las métricas medidas", una afirmación que la tabla de benchmarks anterior respalda en parte, específicamente en tareas agénticas y de codificación. Un tema recurrente, nada sorprendente para un anuncio sin pesos adjuntos todavía, fueron variaciones de "hablar es gratis, muéstrame los pesos", junto con un rechazo puntual a que una empresa se presente como abierta mientras restringe el lanzamiento real. Otros hilos cubrieron terreno práctico genuinamente útil: estimaciones de que ejecutar Beam en local con cuantización de 4 bits necesitaría algo como dos máquinas de memoria unificada de 128 GB, y notas sobre que Beam no tiene soporte de visión donde algunos competidores sí lo tienen. Una línea de discusión distinta y recurrente fue el escepticismo sobre el propio planteamiento de "alternativa occidental a los laboratorios chinos", con algunos comentaristas argumentando que el origen nacional pesaba más en la propuesta que las cifras de los benchmarks.
En r/LocalLLaMA, según se informa, los moderadores retiraron el hilo inicial del anuncio del 5 de octubre por violar la regla del subreddit contra el "vaporware", ya que todavía no había pesos públicos. Una vez llegaron los benchmarks y, más tarde, los pesos reales, el planteamiento más habitual allí fue que Beam se sitúa aproximadamente al nivel de GLM-5.2, siendo el atractivo principal para usuarios serios la soberanía de datos y la procedencia no china para despliegues donde eso importa específicamente, y no que Beam sea la opción más fuerte disponible en capacidad pura.
¿Deberías usarlo?
- Necesitas un modelo genuinamente de pesos abiertos y no chino para un despliegue sensible a la soberanía (gobierno, empresa regulada, entorno air-gapped): un buen ajuste, y posiblemente el diferenciador más claro de Beam, con Dell y HPE ya preparados como socios on-prem.
- Estás eligiendo un modelo de pesos abiertos únicamente por capacidad: un ajuste más débil. Kimi K3 lidera en razonamiento bruto y benchmarks agénticos según las propias cifras publicadas por Reflection, y Muse Spark Open de Meta puntúa más alto en el Intelligence Index de Artificial Analysis.
- Quieres autoalojarlo en tu propio hardware: solo es realista con GPUs de clase centro de datos (mínimo aproximadamente un único nodo 8xH200); no es una opción en hardware de consumo.
- Necesitas fiabilidad factual para investigación o trabajo con muchas citas: un ajuste débil por sí solo. La tasa de alucinación de aproximadamente el 47% en AA-Omniscience es un riesgo real; combínalo con recuperación o fundamentación en fuentes en vez de confiar en respuestas sin apoyo.
- Quieres ejecuciones agénticas de codificación rápidas y relativamente baratas, y puedes tolerar que vaya por detrás del nivel absolutamente más alto: un ajuste razonable, dada su velocidad de salida en el puesto 2 de 77 y su coste por debajo de la mediana por tarea del Intelligence Index.
La gente también pregunta
¿Beam de Reflection AI es realmente de código abierto?
Es de pesos abiertos, no completamente de código abierto. Los pesos, el tokenizador y una implementación de referencia son públicos bajo Apache 2.0, confirmado por la empresa en el lanzamiento del 16 de octubre de 2026. Los datos de entrenamiento y el código de entrenamiento completo no se han publicado, que es la distinción estándar entre "pesos abiertos" y "código abierto" para modelos grandes.
¿Puedo ejecutar Beam en mi propio ordenador?
No en una GPU de consumo ni en un portátil. Incluso con la cuantización más agresiva (NVFP4/INT4), el modelo completo necesita aproximadamente 250-360 GB de memoria porque los 501.000 millones de parámetros deben permanecer en memoria sin importar cuántos se activen por token. El mínimo realista es un único nodo de centro de datos 8xH200.
¿Es Beam mejor que DeepSeek, Qwen o Kimi K3?
No en capacidad bruta. La propia tabla de benchmarks publicada por Reflection muestra a Kimi K3 y DeepSeek V4.1 Flash superando a Beam en la mayoría de benchmarks agénticos y de codificación (Terminal-Bench, DeepSWE, BrowseComp). La propuesta de Beam es la eficiencia de inferencia y la procedencia estadounidense/no china, no ganar en comparación directa de puntuaciones.
¿Es el mismo "Reflection" que tuvo el escándalo de benchmarks falsos en 2024?
No. Aquello fue otra empresa, HyperWrite de Matt Shumer, cuyo modelo alojado "Reflection 70B" resultó estar redirigiendo las peticiones a Claude en vez de ejecutar el modelo que afirmaba. Reflection AI, fundada en 2024 por los antiguos investigadores de Google DeepMind Misha Laskin e Ioannis Antonoglou y respaldada por Nvidia, Sequoia y Lightspeed, es una empresa sin relación alguna.
¿Cuándo se lanzaron en realidad los pesos de Beam?
Reflection anunció Beam el 5 de octubre de 2026 con acceso anticipado solo mediante lista de espera. Los pesos abiertos completos, los informes técnico y de seguridad, y las integraciones con socios se activaron el 16 de octubre de 2026, casi dos semanas después, un hueco que precede a buena parte de la cobertura de la semana de lanzamiento.
¿Es Beam el mejor modelo de pesos abiertos hecho fuera de China?
No según el propio Intelligence Index de Artificial Analysis. Muse Spark Open de Meta, un modelo de pesos abiertos de 816.000 millones de parámetros lanzado bajo la propia licencia de Meta, puntúa 39 frente al 30 de Beam en el mismo benchmark independiente, lo que convierte a Beam en el segundo modelo de pesos abiertos de origen estadounidense, no en el primero.