Beam, Reflection AI का 501-बिलियन-पैरामीटर स्पार्स मिक्सचर-ऑफ़-एक्सपर्ट्स मॉडल है (प्रति टोकन 23 बिलियन एक्टिव), जिसकी घोषणा 5 अक्टूबर 2026 को हुई और जो 16 अक्टूबर को Apache 2.0 के तहत ओपन वेट्स के रूप में रिलीज़ हुआ। वेट्स Hugging Face पर BF16, FP8 और NVFP4 में लाइव हैं, साथ ही एक फ़र्स्ट-पार्टी API पब्लिक बीटा में है और 40 से ज़्यादा लॉन्च पार्टनर्स हैं, जिनमें AWS, Google Cloud, Oracle, Cloudflare और OpenRouter शामिल हैं।
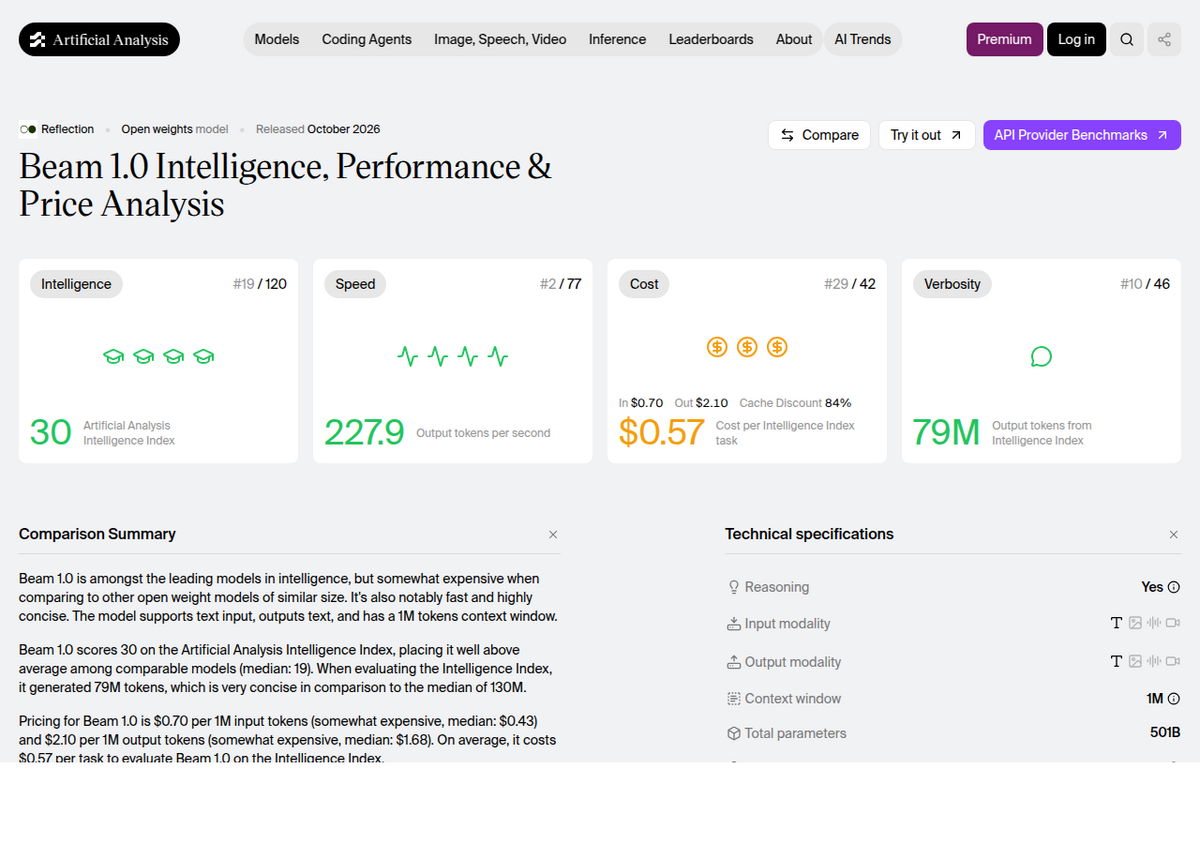
स्वतंत्र रूप से, यह Artificial Analysis के Intelligence Index पर 30 स्कोर करता है (तुलनीय मॉडलों के लिए मीडियन: 19), लिखे जाने के वक़्त ट्रैक किए गए 120 मॉडलों में 19वें स्थान पर। यह तेज़ है (227.9 आउटपुट टोकन/सेकंड, मापे गए 77 मॉडलों में 2रे स्थान पर) और प्रति टास्क चलाना अपेक्षाकृत सस्ता है, पर यह उपलब्ध सबसे मज़बूत ओपन-वेट मॉडल नहीं है: Moonshot का Kimi K3 इसे ज़्यादातर रीज़निंग और एजेंटिक बेंचमार्क पर हरा देता है, और Reflection की अपनी प्रकाशित टेबल भी यही मानती है।
इसे गंभीर हार्डवेयर चाहिए। सिर्फ़ BF16 पर वेट्स ही क़रीब 1TB के हैं; FP8 पर भी आपको क़रीब एक सिंगल 8xH200 नोड जैसा कुछ चाहिए। किसी लैपटॉप या सिंगल कंज़्यूमर GPU पर इसे चलाने का कोई व्यावहारिक तरीक़ा नहीं है।
इसका 2024 वाले "Reflection 70B" विवाद से कोई संबंध नहीं है, जहां एक अलग कंपनी का होस्टेड "70B" मॉडल असल में चुपचाप रिक्वेस्ट्स को Claude की तरफ़ रूट कर रहा निकला था। Reflection AI (2024, Misha Laskin और Ioannis Antonoglou द्वारा स्थापित) एक असंबंधित कंपनी है, एक ऐसा कन्फ़्यूज़न जो डेवलपर फ़ोरम्स में इतनी बार आता है कि इसे साफ़ तौर पर बता देना ज़रूरी है।
Beam असल में क्या है
Beam एक स्पार्स मिक्सचर-ऑफ़-एक्सपर्ट्स मॉडल है: 501 बिलियन टोटल पैरामीटर, पर इनमें से सिर्फ़ 23 बिलियन किसी भी दिए गए टोकन के लिए एक्टिव होते हैं, 52 लेयर्स में फैले हुए, इंटरलीव्ड लोकल और ग्लोबल अटेंशन के साथ और एक्सपर्ट्स के बीच aux-loss-free लोड बैलेंसिंग के साथ। यह सिर्फ़-टेक्स्ट है, इनपुट और आउटपुट दोनों में: कोई इमेज जनरेशन नहीं, और यह विज़ुअल कॉन्टेंट पर सिर्फ़ तब रीज़न कर सकता है जब वह कॉन्टेंट पहले किसी और चीज़ द्वारा टेक्स्ट में बदला जाए। Reflection की अपनी घोषणा इसे सीधे कोडिंग, रीज़निंग और एजेंटिक काम के लिए बताती है, सामान्य चैट के लिए नहीं।
प्रीट्रेनिंग डेटा वह हिस्सा है जिस पर Reflection सबसे ज़्यादा शब्द ख़र्च करता है। कंपनी का कहना है कि उसने सामान्य रॉ इंटरनेट क्रॉल से शुरुआत की और क्यूरेशन के ज़रिए इसका क़रीब 95% हिस्सा हटा दिया, और क़रीब 1.8 ट्रिलियन टोकन के ऐसे मटीरियल पर पहुंचा जिसे वह असल में हाई-क्वालिटी बताता है, जिसे पारंपरिक फ़िल्टर मिस कर देते, और यह 23.8 ट्रिलियन टोकन की टोटल प्रीट्रेनिंग रन में शामिल हुआ। कॉन्टेक्स्ट विंडो 1 मिलियन टोकन है, पर यह आंकड़ा एक मिड-ट्रेनिंग एक्सटेंशन स्टेप के ज़रिए हासिल होता है; इसके बाद आने वाला रीइनफ़ोर्समेंट-लर्निंग फ़ेज़ ख़ुद 256,000 टोकन पर कैप्ड है, एक फ़र्क़ जो जानने लायक़ है अगर आप Beam को ख़ासतौर पर बहुत-लॉन्ग-कॉन्टेक्स्ट एजेंटिक टास्क के लिए जांच रहे हैं, न कि सिर्फ़ लंबे सिंगल डॉक्यूमेंट्स के लिए।
ट्रेनिंग रन, उन नंबरों में जो ज़्यादातर मॉडल घोषणाएं पब्लिश नहीं करतीं
Beam कैसे बनाया गया, इस बारे में Reflection असामान्य रूप से स्पेसिफ़िक है, और दोनों ट्रेनिंग फ़ेज़ों में अलग-अलग हार्डवेयर इस्तेमाल हुआ। प्रीट्रेनिंग 6,144 Nvidia GB300 NVL72 GPUs पर चार हफ़्तों से कम वक़्त में चली, रन के आख़िर में 92.3% गुडपुट (वह हिस्सा जो GPU टाइम असल में काम का ट्रेनिंग प्रोग्रेस दे रहा था) तक पहुंची, और ग्रेडिएंट स्पाइक्स या संदिग्ध साइलेंट डेटा करप्शन से ट्रिगर हुए 9 सेमी-ऑटोमैटिक रीवाइंड्स के साथ। इसके बाद रीइनफ़ोर्समेंट लर्निंग अलग से 10,500 GB300 GPUs पर चार हफ़्तों तक चली, जिसमें 10 करोड़ से ज़्यादा रोलआउट्स जेनरेट हुए, जिनमें से क़रीब 8 करोड़ ख़ासतौर पर एक "reasoning expert" सब-कॉम्पोनेंट की तरफ़ डायरेक्ट किए गए। पीक पर, RL रन ने औसतन क़रीब 110,000 कंकरेंट रोलआउट्स और 170,000 तक कंकरेंट सैंडबॉक्स बरक़रार रखे, क़रीब 1 मिलियन ज़्यादातर-सिंथेटिक RL एनवायरनमेंट्स के मुक़ाबले 1.3 बिलियन टोटल सैंडबॉक्स इनवोकेशन। कहा जाता है कि वेट अपडेट्स लाइव इन्फ़रेंस फ़्लीट तक औसतन क़रीब 12 सेकंड में पहुंचे, और रन ने ट्रेनिंग रोके बिना 71 इन्फ़रेंस इंसिडेंट्स को झेला, हर बार औसतन 8 मिनट में रिकवर करते हुए।
ये दोनों GPU काउंट्स, प्रीट्रेनिंग के लिए 6,144 और RL के लिए 10,500, अलग-अलग थर्ड-पार्टी आर्टिकल्स में ऐसे दिखते हैं जैसे ये एक-दूसरे के उलट हों। ऐसा नहीं है: एक प्रीट्रेनिंग क्लस्टर है, दूसरा बाद में चला कहीं बड़ा रीइनफ़ोर्समेंट-लर्निंग क्लस्टर है, और इन दोनों को मिला देना एक ग़लती है जिससे बचना चाहिए अगर आप इस लॉन्च की बाक़ी कवरेज को क्रॉस-चेक कर रहे हैं।
5 अक्टूबर को घोषित, असल में 16 अक्टूबर को रिलीज़ हुआ
यही वह डिटेल है जिस पर Beam की ज़्यादातर मौजूदा कवरेज पुरानी पड़ जाती है, क्योंकि इसका ज़्यादातर हिस्सा उस गैप में लिखा गया था। Reflection की 5 अक्टूबर वाली घोषणा ने सिर्फ़ एक वेटलिस्ट के ज़रिए अर्ली एक्सेस खोली, और कंपनी ने कहा कि वेट्स, एक टेक्निकल रिपोर्ट और डेवलपर टूल्स "आने वाले हफ़्तों में" आएंगे जबकि मॉडल अपने बताए गए फ़ाइनल सिक्योरिटी चेक्स पूरे कर रहा था। ग्यारह दिन बाद, Reflection ने एक दूसरी पोस्ट पब्लिश की, "Beam is now available," जिसकी तारीख़ 16 अक्टूबर 2026 है, जिसमें पूरी रिलीज़ की पुष्टि हुई: Hugging Face पर ओपन वेट्स (BF16, FP8 और NVFP4 फ़ॉर्मेट, साथ ही एक अलग स्पेक्युलेटिव-डिकोडिंग ड्राफ़्टर मॉडल), एक पुष्ट Apache 2.0 लाइसेंस, platform.reflection.ai पर एक फ़र्स्ट-पार्टी API पब्लिक बीटा में जिसे "फ़्री टू स्टार्ट" बताया गया, और एक सेफ़्टी टेक्निकल रिपोर्ट जो सेफ़्टी ट्रेनिंग के लिए एक मल्टी-टीचर ऑन-पॉलिसी डिस्टिलेशन अप्रोच को कवर करती है।
यह रिलीज़ 40 से ज़्यादा लॉन्च पार्टनर्स के साथ पहले से तैयार हालत में आई: क्लाउड प्लेटफ़ॉर्म्स (AWS, Google Cloud, Microsoft Foundry, Oracle, Cloudflare, CoreWeave, Databricks), इन्फ़रेंस मार्केटप्लेसेज़ (Together AI, OpenRouter, Baseten, Fireworks, Nebius, Modal), Nvidia की अपनी NIM माइक्रोसर्विसेज़, लोकल-इन्फ़रेंस टूल्स (Ollama, LM Studio), ऑन-प्रेम और सॉवरेन/एयर-गैप्ड डिप्लॉयमेंट पार्टनर्स (Dell, HPE), और उन ओपन-सोर्स सर्विंग स्टैक्स में डे-ज़ीरो सपोर्ट जो डेवलपर्स असल में इस्तेमाल करते हैं (Transformers, vLLM, SGLang, Unsloth, Axolotl)। Vercel ने लॉन्च विंडो के लिए इसे अपने AI Gateway पर मुफ़्त चलाया। एक दो-हफ़्ते पुरानी कंपनी की घोषणा के लिए यह वाक़ई एक व्यापक डिस्ट्रिब्यूशन पुश है, और यही सबसे बड़ी वजह है कि इस मॉडल का हवाला देते वक़्त 16 अक्टूबर वाली रिलीज़ को, न कि 5 अक्टूबर वाले टीज़र को, असली लॉन्च तारीख़ माना जाए।
यह कैसे बेंचमार्क करता है, स्वतंत्र रूप से और Reflection की अपनी टेबल के मुताबिक़
Artificial Analysis, जो किसी वेंडर के ख़ुद-रिपोर्ट किए स्कोर की बजाय हर मॉडल को एक जैसे स्टैंडर्डाइज़्ड Intelligence Index से गुज़ारता है, Beam को 30 पर रखता है, 19 के कैटेगरी मीडियन के मुक़ाबले, जो इसे ट्रैक किए गए 120 मॉडलों में 19वें स्थान पर रखता है। यह एक ठोस ऊपर-मीडियन नतीजा है। यह ख़ासतौर पर तेज़ भी है (227.9 आउटपुट टोकन प्रति सेकंड, मापे गए 77 मॉडलों में 2रे स्थान पर) और अपेक्षाकृत संक्षिप्त है (पूरा Index चलाने के लिए 79 मिलियन टोकन, 130-मिलियन-टोकन मीडियन के मुक़ाबले), जो इसकी प्रति-टास्क कॉस्ट को $0.57 पर रखता है, भले ही इसकी प्रति-टोकन प्राइसिंग ($0.70 इनपुट, $2.10 आउटपुट प्रति मिलियन टोकन) को Artificial Analysis ख़ुद फ़ील्ड के मुक़ाबले "कुछ महंगा" बताता है।
Benchmark (Reflection's own table,      Beam    GLM-5.2   Kimi K3   Qwen 3.8   DeepSeek
updated 8 Oct 2026)                                                    Max       V4.1 Flash
-----------------------------------------------------------------------------------------
SWE-Bench Pro v1                        65.5     62.1       NR       67.7        NR
Terminal-Bench v2.1                     80.1     81.0      88.3      86.6       90.6
DeepSWE v1.1                            44.4     44.0      68.0      51.0       74.2
GPQA Diamond                            90.5     91.2      93.5      92.6       90.9
tau3 banking (agentic tool use)         38.0     37.1      37.1      55.2         NR
BrowseComp                              77.4       NR      91.2        NR         NR
HLE, no tools                           36.2     40.5      46.9      43.6       39.1

Figures are Reflection AI's own published comparison table. NR means
Reflection didn't report that model on that benchmark.
SWE-bench Verified (Beam: 80.9) is omitted here because Reflection's table
only compares it against two other models on that specific benchmark, not
this set.
इस टेबल को वैसे ही पढ़ें जैसे Reflection ख़ुद इसे फ़्रेम करता है, क्योंकि कंपनी इस बारे में साफ़ है कि Beam कहां हारता है। इसका हेडलाइन दावा यह है कि Beam, Z.ai के GLM-5.2 के मुक़ाबले एडवांस्ड रीज़निंग पर क़रीब बराबर परफ़ॉर्म करता है, तीन से चार गुना कम इन्फ़रेंस कंप्यूट पर, एक आंकड़ा जिसे Reflection साफ़ तौर पर एक अंदाज़ा बताता है (2 × एक्टिव पैरामीटर × औसत जेनरेटेड टोकन के तौर पर गिना गया, थर्ड-पार्टी टोकन काउंट्स इस्तेमाल करते हुए), कोई मापी गई डॉलर कॉस्ट नहीं। यह तुलना GLM-5.2 के मुक़ाबले भी है, Z.ai के नए GLM-5.3 के मुक़ाबले नहीं, जो ऊपर वाली टेबल की लगभग हर पंक्ति में Beam से ज़्यादा स्कोर करता है। और Reflection बिना किसी हिचकिचाहट के सीधे कहता है कि Moonshot का Kimi K3 रॉ क्षमता पर आगे है: Kimi K3 एक 2.8-ट्रिलियन-पैरामीटर नेटिवली मल्टीमोडल मॉडल है जिसका Artificial Analysis Intelligence Index क़रीब 57 है, जो Claude Opus 5.5 के लगभग बराबर है और Beam के 30 से काफ़ी आगे है। Beam की पिच एफ़िशिएंसी और US प्रॉवेनन्स है, क्षमता में हेड-टू-हेड जीतना नहीं।
Beam पर किसी भी फ़ैक्चुअल चीज़ के लिए भरोसा करने से पहले एक नंबर फ़्लैग करने लायक़ है: Artificial Analysis के AA-Omniscience बेंचमार्क पर, जो मापता है कि कोई मॉडल कितनी बार भरोसे से कोई झूठी बात कहता है, Beam की हैलुसिनेशन रेट क़रीब 47% है, वहीं इसी टेस्ट पर सही-जवाब रेट क़रीब 33% है। रिसर्च या साइटेशन-हैवी काम के लिए यह जिस रेशियो की उम्मीद होनी चाहिए उससे काफ़ी बुरा है, और यह इस बात की एक अच्छी दलील है कि Beam को रिट्रीवल या सोर्स-ग्राउंडिंग (वह काम जो Gemini Notebook नेटिवली करता है) के साथ जोड़ा जाए, बजाय इसके कि इसके बिना-सहायता वाले फ़ैक्चुअल दावों पर भरोसा किया जाए।
क्या Beam असल में सबसे बेहतर "पश्चिमी" ओपन-वेट मॉडल है? पूरी तरह नहीं
लॉन्च-वीक के कई आर्टिकल्स ने Beam को Chinese ओपन-वेट लैब्स के जवाब में सबसे आगे का US-निर्मित मॉडल बताया, बिना यह जांचे कि उसी विंडो में और क्या शिप हुआ था। Artificial Analysis के अपने Intelligence Index पर, Meta का Muse Spark Open, एक 816-बिलियन-पैरामीटर ओपन-वेट मॉडल (42 बिलियन एक्टिव) जो Meta के अपने Muse Model License के तहत रिलीज़ हुआ, 39 स्कोर करता है, Beam के 30 से आगे। इस पैमाने पर यह Beam को पहला नहीं, दूसरे स्थान का US-origin ओपन-वेट मॉडल बनाता है। (Muse Spark Open, Meta के Muse Wonder से अलग मॉडल है, जो एक क्लोज़्ड फ़्रंटियर मॉडल है जिसे Meta ने उसी महीने शिप किया; साझा "Muse" ब्रांडिंग की वजह से इन दोनों को मिला देना आसान है, पर एक ओपन-वेट है और दूसरा नहीं।) यह एक छोटा सुधार है, पर अगर आप किसी मॉडल को ख़ासतौर पर उसके ओरिजिन की वजह से चुन रहे हैं, उसके बेंचमार्क स्कोर की बजाय, तो यह सही जान लेने लायक़ बात है।
क्या आप इसे असल में ख़ुद चला सकते हैं
किसी लैपटॉप पर नहीं, और किसी सिंगल कंज़्यूमर GPU पर भी नहीं। क्योंकि Beam एक मिक्सचर-ऑफ़-एक्सपर्ट्स मॉडल है, इसके 501 बिलियन पैरामीटरों में से सिर्फ़ 23 बिलियन प्रति टोकन एक्टिव होते हैं, जो इन्फ़रेंस कंप्यूट को कम रखता है, पर सभी 501 बिलियन पैरामीटर अब भी मेमोरी में रहने चाहिए, चाहे किसी भी रिक्वेस्ट के लिए कोई भी एक्सपर्ट्स एक्टिव हों। फ़ुल BF16 प्रिसीज़न पर यह क़रीब 1TB की वेट मेमोरी है; FP8 या INT8 इसे क़रीब 500-600GB तक ला देता है; सबसे ज़्यादा एग्रेसिव NVFP4/INT4 क्वांटाइज़ेशन आपको क़रीब 250-360GB तक ले जाता है। सेल्फ़-होस्टिंग की व्यावहारिक सबसे कम सीमा एक सिंगल 8xH200 (प्रति GPU 141GB) नोड है जो FP8 पर चलता है, या दो 8xH100 (80GB) नोड्स जो टेंसर और पाइपलाइन पैरेलेलिज़्म के साथ बंटे हैं। यह एक डेटासेंटर-टियर मॉडल है, कोई हॉबीइस्ट वाला नहीं, जो इसे घर पर चलाने का तरीक़ा ढूंढने से पहले जान लेना ज़रूरी है।
अगर आप इसे होस्ट करने की बजाय सिर्फ़ इस्तेमाल करना चाहते हैं, तो प्राइसिंग प्रोवाइडर के हिसाब से काफ़ी अलग है: OpenRouter इसे प्रति मिलियन टोकन क़रीब $0.25 इनपुट / $1.00 आउटपुट पर सूचीबद्ध करता है, जबकि Artificial Analysis का अपना मापा गया प्रोवाइडर्स में मीडियन $0.70/$2.10 के क़रीब है। यहां दिए गए किसी भी एक नंबर को एक तय क़ीमत की बजाय एक स्नैपशॉट मानें, और जो भी प्रोवाइडर आप असल में इस्तेमाल कर रहे हैं उसकी लाइव रेट जांच लें, क्योंकि Beam 40 से ज़्यादा होस्टिंग पार्टनर्स के साथ लॉन्च हुआ और वे सभी इसकी क़ीमत एक जैसी नहीं रखते।
डेवलपर्स असल में क्या कह रहे हैं
Beam की मूल घोषणा पर Hacker News थ्रेड (556 पॉइंट्स, 173 कमेंट्स) माहौल समझने के लिए काम का है, और यह लगभग पूरी तरह 16 अक्टूबर वाली रिलीज़ से पहले चला। सबसे ज़्यादा अपवोट की गई ठोस आलोचना ने Beam की सीधे DeepSeek के V4.1 Flash से तुलना की: एक कमेंटर ने लिखा कि Beam "DeepSeek v4.1 Flash से बड़ा लगता है, चलाना ज़्यादा महंगा है, और हर मापे गए मेट्रिक पर बुरा है," एक दावा जिसे ऊपर वाली बेंचमार्क टेबल ख़ासतौर पर एजेंटिक और कोडिंग टास्क पर आंशिक रूप से सही साबित करती है। एक बार-बार आने वाला थीम, जो वेट्स अटैच न होने वाली किसी घोषणा के लिए हैरानी की बात नहीं, "बातें करना आसान है, मुझे वेट्स दिखाओ" जैसी बातें थीं, साथ ही यह पॉइंटेड पुशबैक कि किसी कंपनी को ख़ुद को ओपन बताकर असली रिलीज़ को गेट नहीं करना चाहिए। दूसरे थ्रेड्स ने वाक़ई काम के व्यावहारिक पहलू कवर किए: अंदाज़े कि Beam को लोकली 4-बिट क्वांटाइज़ेशन पर चलाने के लिए दो 128GB यूनिफ़ाइड-मेमोरी मशीनों जैसा कुछ चाहिए होगा, और नोट्स कि Beam में विज़न सपोर्ट नहीं है जहां कुछ कॉम्पिटिटर्स में है। चर्चा की एक अलग, बार-बार आने वाली धारा "Chinese लैब्स के पश्चिमी विकल्प" वाली फ़्रेमिंग पर ही संदेह थी, कुछ कमेंटर्स का कहना था कि पिच में नेशनल ओरिजिन, बेंचमार्क नंबरों से ज़्यादा काम कर रहा था।
r/LocalLLaMA पर, मॉडरेटर्स ने कथित तौर पर 5 अक्टूबर वाली शुरुआती घोषणा वाले थ्रेड को सबरेडिट के no-vaporware नियम के उल्लंघन की वजह से हटा दिया, क्योंकि अभी कोई वेट्स पब्लिक नहीं थे। एक बार बेंचमार्क और, बाद में, असली वेट्स आने के बाद, वहां ज़्यादा सामान्य फ़्रेमिंग यह थी कि Beam क़रीब-क़रीब GLM-5.2 के बराबर बैठता है, और सीरियस यूज़र्स के लिए मुख्य खिंचाव डेटा सॉवरेनिटी और नॉन-Chinese प्रॉवेनन्स है, उन डिप्लॉयमेंट्स के लिए जहां यह ख़ासतौर पर मायने रखता है, न कि Beam का रॉ क्षमता पर उपलब्ध सबसे मज़बूत ऑप्शन होना।
क्या आपको इसे इस्तेमाल करना चाहिए
- आपको किसी सॉवरेनिटी-सेंसिटिव डिप्लॉयमेंट के लिए एक नॉन-Chinese, असल में ओपन-वेट मॉडल चाहिए (सरकार, रेगुलेटेड एंटरप्राइज़, एयर-गैप्ड एनवायरनमेंट): एक मज़बूत फ़िट, और शायद Beam का सबसे साफ़ डिफ़रेंशियेटर, Dell और HPE के पहले से ऑन-प्रेम पार्टनर्स के तौर पर सेटअप होने के साथ।
- आप सिर्फ़ क्षमता के आधार पर कोई ओपन-वेट मॉडल चुन रहे हैं: एक कमज़ोर फ़िट। Reflection के अपने प्रकाशित नंबरों के मुताबिक़ Kimi K3, रॉ रीज़निंग और एजेंटिक बेंचमार्क पर आगे है, और Meta का Muse Spark Open, Artificial Analysis के Intelligence Index पर ज़्यादा स्कोर करता है।
- आप अपने ख़ुद के हार्डवेयर पर सेल्फ़-होस्ट करना चाहते हैं: यह सिर्फ़ डेटासेंटर-क्लास GPUs के साथ व्यावहारिक है (कम से कम क़रीब एक सिंगल 8xH200 नोड); कंज़्यूमर हार्डवेयर पर यह कोई ऑप्शन नहीं है।
- आपको रिसर्च या साइटेशन-हैवी काम के लिए फ़ैक्चुअल भरोसेमंदी चाहिए: अपने-आप में एक कमज़ोर फ़िट। AA-Omniscience पर क़रीब 47% वाली हैलुसिनेशन रेट एक असली ख़ामी है; बिना-सहायता वाले जवाबों पर भरोसा करने की बजाय इसे रिट्रीवल या सोर्स-ग्राउंडिंग के साथ जोड़ें।
- आपको तेज़, अपेक्षाकृत सस्ते एजेंटिक कोडिंग रन चाहिए और आप इसके बिल्कुल टॉप टियर से पीछे रहने को बर्दाश्त कर सकते हैं: एक वाजिब फ़िट, इसकी 77 में से 2रे स्थान वाली आउटपुट स्पीड और प्रति Intelligence Index टास्क नीचे-मीडियन कॉस्ट को देखते हुए।
लोग यह भी पूछते हैं
क्या Reflection AI का Beam असल में ओपन सोर्स है?
यह ओपन-वेट है, पूरी तरह ओपन-सोर्स नहीं। वेट्स, टोकनाइज़र और एक रेफ़रेंस इम्प्लिमेंटेशन Apache 2.0 के तहत पब्लिक हैं, जिसकी पुष्टि कंपनी ने 16 अक्टूबर 2026 वाली रिलीज़ पर की। ट्रेनिंग डेटा और पूरा ट्रेनिंग कोड रिलीज़ नहीं किया गया, जो बड़े मॉडलों के लिए "ओपन-वेट" और "ओपन-सोर्स" के बीच का स्टैंडर्ड फ़र्क़ है।
क्या मैं Beam को अपने ख़ुद के कंप्यूटर पर चला सकता हूं?
किसी कंज़्यूमर GPU या लैपटॉप पर नहीं। सबसे ज़्यादा एग्रेसिव क्वांटाइज़ेशन (NVFP4/INT4) पर भी, फ़ुल मॉडल को क़रीब 250-360GB मेमोरी चाहिए क्योंकि सभी 501 बिलियन पैरामीटर रेज़िडेंट रहने चाहिए, चाहे प्रति टोकन कितने भी एक्टिव हों। व्यावहारिक सबसे कम सीमा एक सिंगल 8xH200 डेटासेंटर नोड है।
क्या Beam, DeepSeek, Qwen या Kimi K3 से बेहतर है?
रॉ क्षमता पर नहीं। Reflection की अपनी प्रकाशित बेंचमार्क टेबल में Kimi K3 और DeepSeek V4.1 Flash, Beam को ज़्यादातर एजेंटिक और कोडिंग बेंचमार्क (Terminal-Bench, DeepSWE, BrowseComp) पर हरा देते हैं। Beam की पिच इन्फ़रेंस एफ़िशिएंसी और US/नॉन-Chinese प्रॉवेनन्स है, स्कोर पर हेड-टू-हेड जीतना नहीं।
क्या यह वही "Reflection" है जिसका 2024 में फ़ेक-बेंचमार्क स्कैंडल हुआ था?
नहीं। वह एक अलग कंपनी थी, Matt Shumer की HyperWrite, जिसका होस्टेड "Reflection 70B" मॉडल असल में बताए गए मॉडल को चलाने की बजाय रिक्वेस्ट्स को Claude की तरफ़ रूट कर रहा निकला था। Reflection AI, जो 2024 में पूर्व Google DeepMind रिसर्चर्स Misha Laskin और Ioannis Antonoglou ने शुरू की और जिसे Nvidia, Sequoia और Lightspeed से फ़ंडिंग मिली है, एक असंबंधित कंपनी है।
Beam के वेट्स असल में कब रिलीज़ हुए?
Reflection ने Beam की घोषणा 5 अक्टूबर 2026 को की, सिर्फ़ वेटलिस्ट के ज़रिए अर्ली एक्सेस के साथ। फ़ुल ओपन वेट्स, टेक्निकल और सेफ़्टी रिपोर्ट्स, और पार्टनर इंटीग्रेशन्स 16 अक्टूबर 2026 को लाइव हुए, क़रीब दो हफ़्ते बाद, एक गैप जिससे लॉन्च-वीक की ज़्यादातर कवरेज पहले की है।
क्या Beam, China के बाहर बना सबसे बेहतर ओपन-वेट मॉडल है?
Artificial Analysis के अपने Intelligence Index के मुताबिक़ नहीं। Meta का Muse Spark Open, एक 816-बिलियन-पैरामीटर ओपन-वेट मॉडल जो Meta के अपने लाइसेंस के तहत रिलीज़ हुआ, इसी स्वतंत्र बेंचमार्क पर Beam के 30 के मुक़ाबले 39 स्कोर करता है, जो Beam को पहला नहीं बल्कि दूसरे स्थान का US-origin ओपन-वेट मॉडल बनाता है।