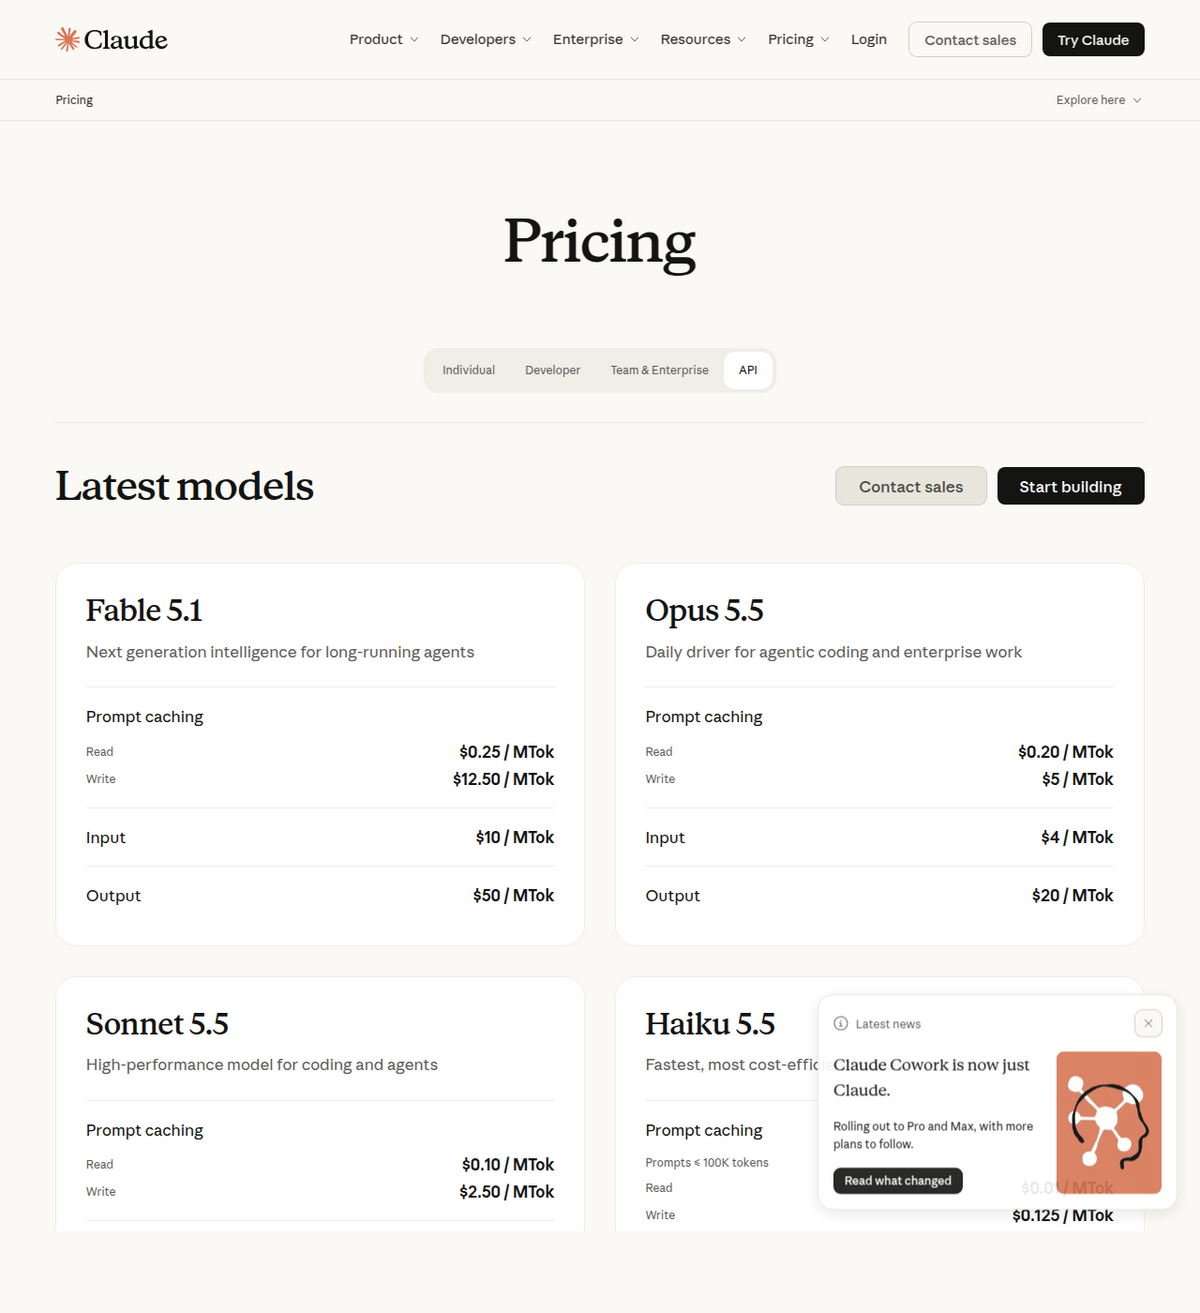
Claude Sonnet 5.5は2026年9月28日にローンチした。Anthropicの「5.5」刷新における2番目のリリースで、Opus 5.5(9月22日)から6日後のことだ。料金はSonnet 5から変わらず、入力100万トークンあたり2ドル、出力100万トークンあたり10ドルのままだ。唯一変わった料金は見落とされがちだ。キャッシュされたプロンプトの読み取り料金が100万トークンあたり0.10ドルへ下がり、Sonnet 5の旧料金0.20ドルの半額になった。私たちが確認した第三者の料金トラッカーのほとんどは、いまだ0.20ドルを現行料金として掲載している。
知識労働系とコンピュータ操作系のベンチマークでは、半額でありながらOpus 5.5とほぼ互角だ。 Sonnet 5.5はGDPval-AA v2.1で1844点を記録し、Opusの1846点に対してわずかな差。OSWorld 2.1でも80.1%対Opusの81.8%で、2倍の価格差があるにもかかわらず差は1〜2ポイントにとどまる。
Anthropic自身が発表した数字と、独立系研究機関による再検証の結果は一致しない。 AnthropicはTerminal-Bench 4.0で70.6%と報告しているが、Artificial Analysisが同じベンチマークを独立して再実行した結果は64%だった。それでもAAのハーネスにおけるOpus 5.5の60%よりは高いものの、宣伝された数字と再現された結果の間には本物のギャップがあり、それを前提に計画を立てる前に知っておく価値がある。
「最大30%安い」という主張は、すべての設定で成立するわけではない。 最大推論エフォート設定では、Sonnet 5.5は1タスクあたり平均およそ193,000個の出力トークンを生成し、これはArtificial Analysisがこれまで計測したどのモデルよりも高い数字だ。その結果、タスクあたりのコストは約7.60ドルまで上昇し、Sonnet 5より高くなるだけでなく、ある計測では、より少なく、より高価なトークンで同じ品質基準に達するOpus 5.5よりも高くなった。
何がリリースされ、どんな順序だったか
私たち自身のOpus 5.5ガイドも、この記事の調査中に訂正するまで順序を逆に記していた。Anthropic自身のモデルドキュメントによれば、Opus 5.5のリリースは2026年9月22日、Sonnet 5.5のリリースはその6日後の9月28日であり、先ではない。この順序は比較の読み方を左右する。Sonnet 5.5は前座ではなく、Opus 5.5が打ち立てたベンチマーク数字を超えようとする後発の役なのだ。
APIのモデルIDはclaude-sonnet-5-5で、Claude API、Amazon Bedrock、Google Cloud Vertex AI、Microsoft Foundry経由で利用できる。コンテキストウィンドウは100万トークンのままで、標準リクエストの出力上限は128Kトークン、Batch APIではoutput-300k-2026-03-24ベータヘッダーの下で300Kトークンまで拡張できる。知識カットオフはトレーニングと信頼できる記憶の両方の観点で2026年6月だ。Sonnet 5から変わった挙動のデフォルトが1つある。Sonnet 5.5はデフォルトで高(high)エフォートで推論する(Opus 5.5のデフォルトはmedium)。また、手動で設定できる最低の思考設定が、以前のdisabledオプションからbetween_toolsに変わった。統合側が明示的に思考をオフに設定していた場合、これは破壊的変更になる。
料金の落とし穴: キャッシュ読み取りが安くなったのに、ほとんどのトラッカーが見落としている
入力・出力の料金はSonnet 5からそのまま変わらず、入力100万トークンあたり2ドル、出力100万トークンあたり10ドルだ。実際に動いたのはプロンプトキャッシュの料金だ。Anthropicのドキュメントには、Sonnet 5.5はSonnet 5と同じ料金を維持するが、「プロンプトキャッシュの読み取りを除く。これは100万トークンあたり0.10米ドルで、Claude Sonnet 5の料金の半額だ」と記されている。キャッシュの書き込みは、5分間キャッシュで100万トークンあたり2.50ドル、1時間キャッシュで100万トークンあたり4ドルのまま変わらない。Batch APIは入力・出力の両方に依然として50%の割引を適用しており、非同期ワークロードでは実質100万トークンあたり1ドル/5ドルになる。
Sonnet 5.5のローンチ後に公開された複数の料金まとめ記事を確認したところ、eesel.aiの料金ガイドを含む複数の記事が、訂正後の0.10ドルではなく、旧Sonnet 5の数字である0.20ドルをキャッシュ読み取り料金としていまだ掲載していた。キャッシュヒット率の高いワークロードの予算を立てている場合、このギャップは積み重なる。主にキャッシュから読み取るワークロードのコストは、古いチャートが示唆する額のおよそ半分になる。予算を確定させる前に、この記事を含む二次的な表ではなく、Anthropic自身のドキュメントに直接照らして料金の主張を確認してほしい。
ベンチマーク: Opusとほぼ互角、ただしベンダー数字と独立検証に1件のギャップ
Benchmark                    Sonnet 5.5   Opus 5.5   Sonnet 5
----------------------------------------------------------------
GDPval-AA v2.1 (knowledge work)    1844         1846        1449
OSWorld 2.1 (partial credit)       80.1%        81.8%       57.0%
OSWorld 2.1 (strict pass)          43.5%        48.7%       25.6%
Terminal-Bench 4.0 (Anthropic)     70.6%        66.4%       10.3%
Terminal-Bench 4.0 (AA re-test)      64%          60%          -
FrontierCode 1.1 (xhigh effort)    52.1%        54.4%       42.4%
CursorBench 4.0                    55.5%        57.8%       34.1%
Humanity's Last Exam (w/ tools)    64.5%        67.7%       54.9%

AA = Artificial Analysis, an independent benchmark lab.
Terminal-Bench shows the largest vendor-vs-independent gap of
any figure checked for this article.
知識労働系ベンチマークのGDPval-AAと、GUI経由で実際のコンピュータを操作する能力を測るOSWorldでは、Sonnet 5.5は半額でありながらOpus 5.5と1〜2ポイントの差に収まる。これはほとんどの報道が見出しにしている内容で、正確でもある。ただ、ほとんどの報道が省略しているのがOSWorldの内訳だ。80.1%という数字は部分点であり、タスクが完全には終わっていなくても進捗があれば加点される。タスクを完全に完了した場合のみを数える厳格な合格率は、Sonnet 5.5が43.5%、Opus 5.5が48.7%で、部分点での1.7ポイント差が厳格な合格では5.2ポイント差まで広がる。タスクを「おおむね終える」のではなく「完全に終える」必要がある用途なら、計画の前提として重視すべき違いだ。
Terminal-Benchのギャップは、それ単独で指摘する価値がある。Anthropicのローンチ資料ではSonnet 5.5が70.6%と報告されている。ベンダーの数字をそのまま受け取らず、自前のハーネスでベンチマークを再実行する独立系研究機関Artificial Analysisが計測した結果は64%で、ベンダーの数字から6ポイント下がっている。それでも、同じハーネスでのOpus 5.5の60%よりは高い。どちらの数字も厳密には「間違い」ではなく、異なるテスト条件を反映しているに過ぎない。だが、企業が報告する数字と独立した第三者が再現する数字の間に6ポイントのギャップがあるという事実は、まじめな比較記事なら必ず触れるべき種類の詳細であり、私たちが確認した競合記事の多くには、この点がほとんど見当たらなかった。
このローンチを取り上げたHacker Newsのスレッド(884ポイント、613件のコメント)は、関連する複雑な論点を提起している。いくつかのエージェント系ベンチマークでSonnet 5.5がOpus 5.5に対して見せる優位の一部は、純粋な能力差ではなく、Opusの安全性ルーティングの挙動を反映しているのかもしれないというものだ。あるコメント投稿者は、Opus 5.5がセーフガードのトリガーによっておよそ10%の試行で弱いモデルへフォールバックしており、同じテストでのSonnetのフォールバック率を大きく上回っていると指摘している。これはAnthropicが確認した数字ではなくコミュニティの観察だが、安価なモデルが特定のテストで高価なモデルにほぼ匹敵し、あるいはわずかに上回り続ける理由として、説得力のある説明だ。
本当のコストの実態: 最大エフォート時のトークン消費の多さ
AnthropicはSonnet 5.5を、Sonnet 5より最大30%低いコストでタスクを処理できるモデルとして売り込んでいる。この主張はAnthropicが選んだタスクの組み合わせとエフォート設定においては本当だが、普遍的には成立しない。そして、実際に料金を支払う立場の人にとって、この記事で最も役に立つ事実はまさにこのギャップにある。Artificial Analysisの計測によれば、Sonnet 5.5は最大推論エフォート設定で1タスクあたり平均およそ193,000個の出力トークンを生成しており、これはAAが追跡しているどのモデルよりも高い記録だ。同じ最大エフォート設定のOpus 5.5やSonnet 5よりおよそ60%多く、同等のタスクにおけるGPT-6 Astraのトークン消費のおよそ7倍にもなる。
このトークン消費の多さは、タスクあたりのコストに直接反映される。AAの計測では、Sonnet 5.5は最大エフォート設定で1タスクあたり約7.60ドルとなり、同じ設定でのSonnet 5のコストよりおよそ50%高い。あるAAの比較では、Opus 5.5がSonnet 5.5の最高品質スコアに1タスクあたり約3.46ドルで到達しており、多くの安価なトークンではなく、少数の高価なトークンでそこに達している。これはSonnet 5.5自身の最大エフォート実行より総額で安い。実務上の教訓はこうだ。Sonnet 5.5の価格優位性は、スコープの明確なタスクに対するデフォルトの高エフォート設定では本物だが、本当に難しい問題で最大エフォートまで押し上げると、その優位性は消えたり逆転したりすることがある。そうした場面では、Opus 5.5の少なく高価なトークンの方が、結局は安く仕事を終わらせることがある。
Sonnet 5.5対Opus 5.5: Anthropic自身が勧める選び方
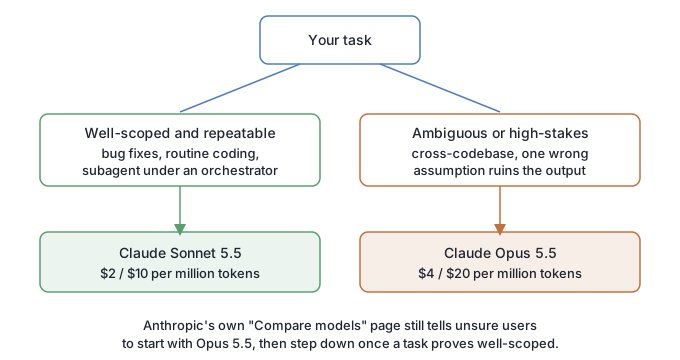
AnthropicはSonnet 5.5をOpus 5.5の置き換えとは位置づけていない。Anthropic自身の発表は、Sonnet 5.5を「Claude Opus 5.5を補完する、より速く低コストなモデル」と呼び、Opusは「慎重な判断を要する複雑な作業」のために確保している。ドキュメントのモデル比較表はさらに率直だ。判断に迷うユーザーには、ほとんどのワークロードでまずOpus 5.5から始めるよう案内し、Sonnetはタスクのスコープが明確だとすでにわかっている場合に切り替える先のモデルとして扱われており、デフォルトの選択肢ではない。
このガイダンスの背後には、ベンチマーク表には直接表れない正確性の本物のトレードオフがある。事実の正確性を測るArtificial AnalysisのOmniscienceテストでは、Opus 5.5が66%、Sonnet 5.5が54%で、Opusの方が単純に正しい事実をより多く知っている。しかしハルシネーション率では、Sonnet 5.5の方が実際に低い(つまり良い)。Sonnet 5.5が47%、Opusが59%で、Sonnet 5.5は全体として持っている知識が少ないにもかかわらず、わからないことがあればそれを認める傾向が強く、当て推量をしにくい。特にリサーチの統合作業では、生の知識量の上限が高いことよりも、実際に試みた範囲でのハルシネーション率の低さの方が重要になる場合がある。欠落に気づきたいのか、自信満々に述べられた誤答に気づきたいのか、どちらを重視するかによって変わってくる。
開発者の議論を支配する不満: セーフガードが日常業務を妨げている
そのHacker Newsスレッドで最も繰り返し叫ばれていたテーマは、料金やベンチマークではなく、Anthropicのサイバーセーフガードシステムが正当な作業をリスクとして誤検知することだった。開発者たちは、ESP32のBluetoothファームウェア、古いCコードのレビュー、write-ahead-logの実装、正式に許可されたバグバウンティ調査といったタスクで、ブロックされたり制限モードへ回されたりしたと報告している。あるコメント投稿者の「ベビーシッター役のツールなど要らない」という要約は、スレッド中で繰り返し共感を呼び、その土台となる「Cyber Verification Program」が明確な異議申し立ての手段もなく誤検知を生んでいるという不満も重ねられた。
2つ目の不満のまとまりは、安全性のルーティングではなく利用上限を中心にしたものだった。複数のユーザーが、課金期間が更新されるかなり前にMaxプランのクォータを使い切ったと報告しており、あるユーザーはOpus 5.5の20倍プランを7日中4日で使い切ったと述べ、別のチームは1日足らずの激しいエージェント利用で月間1万ドルのトークン予算に達したと報告している。どちらの不満もSonnet 5.5の能力に固有のものではないが、エージェント型ワークフローの中でこれを採用する際の実務的なコストに影響し、ベンチマーク表には決して表れない。
独立して行われた1つの比較が、実際の信頼性についてより具体的な感触を与えてくれる。コードレビュープラットフォームのCodeRabbitが実施したテストでは、既知のバグがあらかじめカタログ化された13件のプルリクエストに対し、Sonnet 5.5とSonnet 5を比較した。Sonnet 5.5は13件中6件を検出し、Sonnet 5の13件中4件を上回った。レビューあたりのコストはおよそ60%低く、レイテンシもおよそ半分(平均5分27秒対9分55秒)だった。それでもOpus 5.5はさらに多く検出し、実行ごとに同じ13件中8〜10件を見つけている。これはAnthropic自身の位置づけが説明するパターンと一致する。Sonnet 5.5は同じ価格でSonnet 5からの本物のアップグレードであり、それでも最も重要なケースではOpus 5.5の方がより多く検出する。
Sonnet 5.5対競合勢: GPT-6 Solとパレートの問題
OpenAIのGPT-6 Solは、Sonnet 5.5と同じ100万トークンあたり2ドル/10ドルの価格設定であり、両者はコスト面で直接対決することになる。Sonnet 5.5はGDPval-AA(1844対1487)とAA-Briefcase(1811対1483)で明確にリードし、FrontierCode(52.1%対49.3%)でもわずかに先行する。だがArtificial Analysisは、同じ価格帯で比較すると、Sonnet 5.5は出力トークンあたりの知性のフロンティアから外れていると指摘する。理由は上で述べたのと同じトークン消費の多さの問題だ。生のベンチマークスコアではSonnet 5.5が勝っていても、GPT-6 Solは同程度の価格で出力トークンあたりの実測された能力をより多く提供する。実運用で実際にどちらが安く済むかは、見出しのベンチマーク表だけではなく、自分のワークロードがモデルにどれだけ多くのトークンを使わせてしまうかに大きく左右される。
実際にSonnet 5.5を使うべきなのは誰か
- Sonnet 5.5を使うべき人: ワークロードがスコープの明確な、繰り返し可能な作業の場合——日常的なコーディング、再現手順が明確なバグ修正、あるいはOpusレベルのオーケストレーターの下で動くサブエージェントなど。半額でOpusに近いベンチマークスコアが実際に生かされる場面だ。
- Sonnet 5.5を使うべき人: すでにSonnet 5を使っていて、特に何も変更していない場合。
sonnetモデルエイリアスでのアップグレードは実質的に無料であり、独立したテスト(CodeRabbitのPRレビュー比較、別の実機編集エージェントテスト)は同じ価格での本物の品質向上を示している。 - Opus 5.5へ切り替えるべき場面: タスクが曖昧だったり、不慣れなコードベースにまたがったり、1つの誤った前提がコストの高い結果を招く場合。Opusの優位性は、まさにこうした難しく、スコープの明確でないケースで広がる。
- 最大エフォートで「最大30%安い」と思い込まないこと。 本当に難しい問題でSonnet 5.5を最高の推論設定まで押し上げている場合は、実際のトークン消費を確認してほしい。独立した計測では、Sonnet 5より高くなり、時には同じ結果に達するOpus 5.5より高くなることもあるとわかっている。
- キャッシュ利用の多いワークロードの予算は、読み取り100万トークンあたり0.10ドルで計算すること。 複数の料金トラッカーがいまだ公開している0.20ドルという数字ではない。
よくある質問
Claude Sonnet 5.5はいつローンチしましたか? Opus 5.5より前か後か?
2026年9月28日で、Claude Opus 5.5(2026年9月22日)の6日後であり、前ではない。私たち自身のOpus 5.5ガイドの以前のバージョンでは順序が逆になっていたが、Anthropic自身のドキュメントに照らして検証した後に訂正した。
Claude Sonnet 5.5の料金はいくらですか?
入力100万トークンあたり2ドル、出力100万トークンあたり10ドルで、Sonnet 5から変わらない。キャッシュされたプロンプトの読み取りは100万トークンあたり0.10ドルで、Sonnet 5の旧料金0.20ドルの半額だが、複数の第三者の料金トラッカーはこの変更をいまだ反映していない。Batch APIは標準料金にさらに50%の割引を適用する。
Claude Sonnet 5.5はOpus 5.5と同等の性能ですか?
GDPval-AA(知識労働)とOSWorld(コンピュータ操作)では、Sonnet 5.5は半額でありながらOpus 5.5と1〜2ポイント以内の差だ。Opus 5.5は、より難しくスコープの明確でないベンチマークや、事実の正確性(AA-Omniscienceで66%対54%)で優位に立つ一方、Sonnet 5.5は答えがわからないときに実際によりハルシネーションが少ない(47%対59%)。
Claude Sonnet 5.5は本当にSonnet 5より最大30%安いのですか?
Anthropicが選んだタスクの組み合わせとデフォルトのエフォート設定では、その通りだ。しかし最大推論エフォート設定では、独立したテストにより、Sonnet 5.5がSonnet 5よりタスクあたりはるかに多い出力トークンを生成することがわかっており、その設定でのタスクあたりコストはSonnet 5よりおよそ50%高くなり、時には同じ品質に少ないトークンで達するOpus 5.5よりも高くなる。
なぜSonnetとOpus 5.5のサイバーセーフガードについて不満の声が上がっているのですか?
開発者たちは、ファームウェアのコード、古いCコードのレビュー、正式に許可されたセキュリティ調査といった正当な作業が、Anthropicの Cyber Verification Program によってフラグを立てられたり制限されたりしたと報告している。この不満は特定の誤答についてではなく、日常の開発作業を妨げる誤検知が、解決への明確な手段もないまま起きていることについてのものだ。