Mistral Large 4は2026年10月6日にパブリックプレビューでローンチした。520億のアクティブパラメータを持つMixture-of-Expertsモデルで、この数字はMistral自身のブログと技術文書がいまや一致している値だ。総パラメータ数については、Mistral自身の資料の間でまだ食い違いがある。ブログでは1兆、技術文書では1.05兆、EU AI Act向けの法的申告書ではより曖昧な「1兆超」とされている。VentureBeatのローンチ当日の報道は、別途490億のアクティブパラメータを挙げているが、この数字はMistral自身の現行資料のどこにも見当たらない。
コンテキストウィンドウにも同様のギャップがある。 Mistralは100万トークンだと述べている。独立トラッカーのArtificial AnalysisとVals.aiは、実際には512,000〜524,000トークン前後と計測しており、Artificial Analysis自身のスペック表とFAQすら食い違っている(524kと520k)。
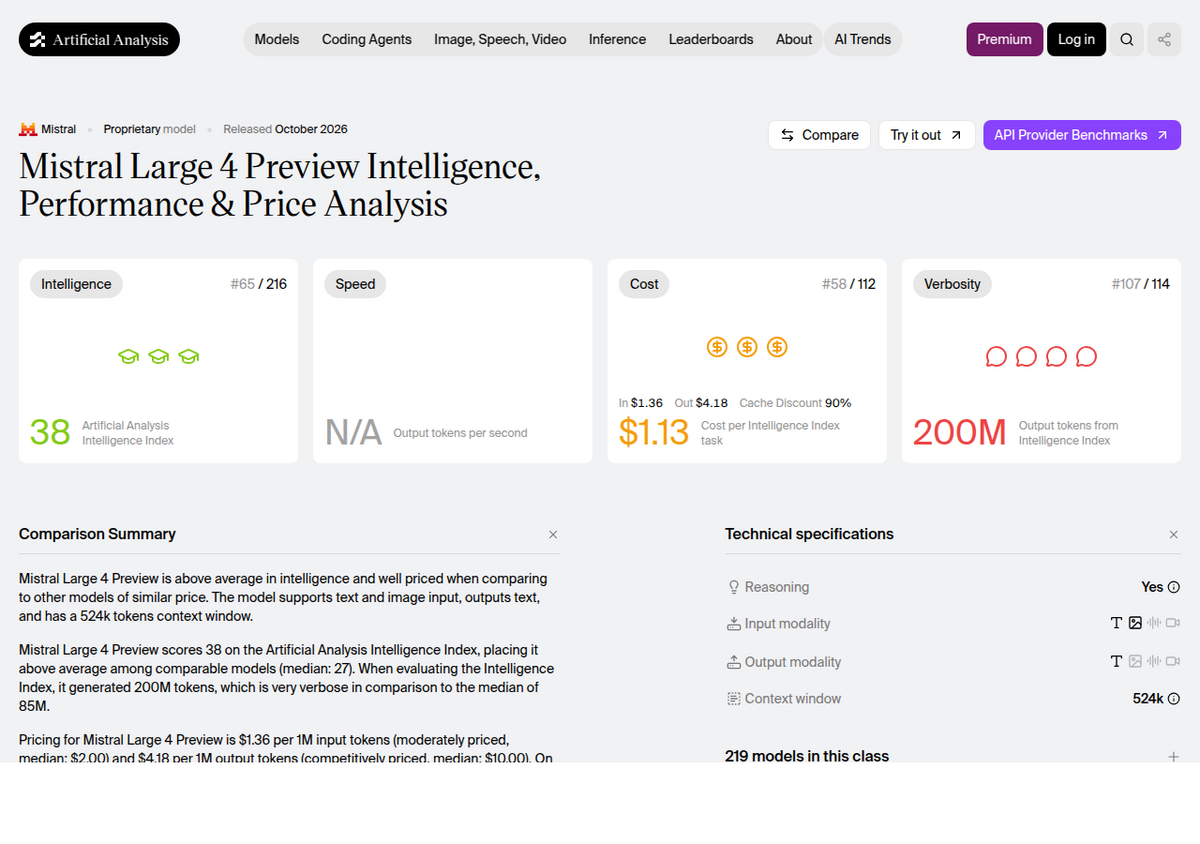
独立検証では、まずまずのスコアだがフロンティア水準ではない。 Artificial AnalysisはIntelligence Indexで38点を付けており、追跡対象216モデル中65位で、カテゴリーの中央値は上回るものの、Claude Opus 5.5(58点)や複数の中国系オープンモデルには大きく後れを取っている。
現時点ではAPI限定で、無料ティアはない。 オープンウェイトはMistralによれば「10月末まで」に提供予定とされているが、確定した日付はない。期間限定の50%オフローンチ割引により、料金は入力100万トークンあたり0.68ドル、出力100万トークンあたり2.09ドルとなり、これはおよそ10月20日まで続く。
Mistral Large 4は実際には何なのか
Mistral Large 4は、Mistralが「オープンウェイトのハイブリッド指示従順・推論」システムと説明するMixture-of-Expertsモデルで、マルチモーダル入力・テキストのみの出力を特徴とする。テキストと画像(Mistral自身のEU AI Act準拠申告書によれば、リクエストあたり最大8枚)を受け付けるが、出力は常にテキストのみで、画像生成は行わない。画像側には別途16億パラメータの専用ビジョンエンコーダーを搭載しており、この詳細はMistralの技術文書で確認できるものの、同社自身のブログ記事やほとんどの報道では触れられていない。APIにはreasoning_effortパラメータが用意されており、「ハイブリッド推論」という位置づけと一致する——回答前にどれだけ考えるかを調整でき、レイテンシと品質を引き換えにできる。
Mistralはおよそ3,800基のNvidia Grace Blackwell GPU(Mistral自身の数字。報道では「約4,000基」と丸められている)を使い、約2ヶ月かけてこのモデルを訓練した。対応言語はEUの全公式言語を含む160以上に及ぶ。Mistralのサイエンス担当VPであるPierre Stock氏はTechCrunchに対し、この訓練には名前を明かしていない中国の競合他社と比べて「2〜3倍少ない」計算量を使ったと述べているが、この効率性に関する主張は独立検証されたものではなく、企業側の発言として留意すべきだ。どのベンチマーク単体でもこのモデルを厳しく評価しすぎる前に重く見るべき詳細がある。Mistral自身のブログは、ローンチ時点で強化学習の訓練が「まだ進行中」だったと述べており、つまりパブリックプレビューのチェックポイントは明確に未完成のモデルであり、Mistralの最終版ではないということだ。
「Le Chonk」というニックネームには、具体的で確認可能な由来がある。2026年6月、「Le Chaton Fat」という架空のモデルについて、30兆パラメータという捏造されたベンチマークとともにネット上でジョークが広まった。Mistral CEOのArthur Mensch氏は当時このジョークに乗ってSNSで反応しており、数ヶ月後にMistral Large 4が実際に本物の超巨大モデルとして出荷されたとき、この社内ニックネームが定着した。Mensch氏は「実はle gros chaton(デブな子猫)だ」とジョークを言ったと報じられている。小さな話ではあるが、Mistralが今回の「大型モデル」という位置づけを自覚し、それを受け入れていることを示す類のエピソードだ。
総パラメータ数は、Mistralのどのページを読むかで変わる
Source                                Total params      Active params
---------------------------------------------------------------------------
Mistral's launch blog post             1 trillion         52 billion
docs.mistral.ai model page              1.05 trillion       52 billion
VentureBeat (launch-day reporting)      1 trillion          49 billion
EU AI Act technical documentation       ">1 trillion"       not disclosed
  (legal filing)

Mistral's blog and technical docs now agree on 52 billion active
parameters. The total count still varies across Mistral's own materials,
and VentureBeat's widely-repeated 49 billion figure doesn't appear in any
current Mistral-published page we could find.
この法的申告書には、別の理由でもう一度目を向ける価値がある。EU域内での事業に必要なコンプライアンス開示である、ダウンストリーム提供者向けのMistralのEU AI Act技術文書は、モデルの最大テキスト入出力を一律「250トークン」としている。これはほぼ確実に、Mistralが正しく記入しなかったテンプレートの項目であり、本物の制限ではない(Mistral自身の文書を含む他のすべての出典は、数十万から100万トークン規模のコンテキストウィンドウを記載している)が、Mistral自身の公式文書に存在する、確認可能な正真正銘の奇妙な点だ。私たちは自動テキスト抽出に頼らず申告書を直接表示して確認したが、その数字はまさにその通りに印刷されている。250トークンを実際の制約として引用してはならないが、このローンチに関するMistralのコンプライアンス文書が拙速に作成されたことを示す兆候として受け止めるべきだ。
コンテキストウィンドウ: 主張は100万トークン、実測はその半分程度
Mistral自身の文書は、100万トークンのコンテキストウィンドウを主張しており、この数字はほとんどのローンチ報道でも繰り返されている。独立系のAPIトラッカーは、実際にはそれより小さい値を計測している。Vals.aiは512,000トークンのコンテキストウィンドウと256,000トークンの最大出力を挙げており、Artificial Analysisのスペック表と自身のFAQページは524,000対520,000トークンで食い違っている。この3つの独立した数字のいずれも、Mistralの100万トークンという主張と一致しておらず、2つの独立トラッカー同士も正確には一致していない。本当に100万トークンのウィンドウを丸ごと使うことに依存するワークフローがあるなら、その数字を前提に構築する前に、自前の長文ドキュメントでテストしておくべきだ。ここでの主張値と実測値のギャップは、無視できないほど大きい。
料金、そしてすでに減っていくタイマーが動いている割引
Tier                      Input ($/M tokens)   Output ($/M tokens)
---------------------------------------------------------------------
List price                 1.36                  4.18
Launch discount (50% off,   0.68                  2.09
  ~2 weeks from 6 Oct)
Cached input, discounted    0.07                  n/a

Mistral's own changelog states the discount runs roughly two weeks from
launch, putting the likely end date around 20 October 2026. No exact end
date is published on the pricing page itself, so confirm the live price
on Mistral's own console before relying on it.
独立計測によるベンチマーク結果
ベンダーの自己申告スコアではなく、すべてのモデルを同一の標準化されたIntelligence IndexにかけているArtificial Analysisは、Mistral Large 4を38点と評価し、追跡対象216モデル中65位、カテゴリーの中央値であるおよそ26〜27点を上回っている。これはMistral自身の前フラッグシップモデル(詳細は後述)からの本物の大きな飛躍であり、平均を上回る結果だが、フロンティア水準ではない。Claude Opus 5.5が58点でトップに立ち、Claude Sonnet 5.5が51.9点、さらに複数のオープンウェイトの中国系モデル——MiMo-V2.6-Pro(46点)、GLM-5.3(45点)、Qwen 3.8 Max(45.4点)——がいずれも同指数でMistral Large 4を上回っている。Mistral自身の「米国と中国以外で最も強力なモデル」という位置づけは、GPT-6 Luna(およそ37〜38点)のような西側の非オープンな競合に対しては成立するが、これらの中国系オープンモデルに対しては成立せず、見出しが示唆するよりもかなり狭い主張だということになる。規模感の参考として、同じ週に行われたもう一つの大きなローンチ、MetaのMuse WonderのAPI経由で利用できるティアは、同じ独立指数で52点を記録し、Mistral Large 4を大きく上回っている。
実際にこのモデルを使うべきかを判断するなら、見出しのスコアより重要な独立した数字が2つある。1つ目はハルシネーション率だ。Artificial AnalysisのAA-Omniscience計測によれば41.9%で、独立レビューアーのeesel.aiはこれを今回のローンチにおける最大の弱点として指摘している。間違っているのに自信満々な回答が高くつくような用途でこのモデルを使う前に知っておく価値がある。2つ目はレイテンシの形状だ。ストリーミングが始まれば、出力は毎秒116トークンというまずまずの速度で進むが、長いプロンプトでの最初のトークンが出るまでの時間(time-to-first-token)はおよそ18.7秒と計測されており、始まれば速いが出だしが遅い。これはライブチャットのインターフェースには悪い組み合わせだが、起動の遅延を許容できるバッチジョブには問題ない。
より強力なフロンティアモデルに偏った別の比較対象セットを使う、もう一つの独立トラッカーであるVals.aiは、相対的にはより低く評価している。Vals Indexで48.05%、47モデル中35位だ。相対的に最も良い結果は、法律文書タスクであるHarveyのLegal Agent Benchmarkで、79モデル中9位という、素の点数(15.83%)だけ見ると見劣りするものの、この種の法的推論ベンチマークは全体的に低いスコアになりがちなことを考えれば立派な順位だ。最も弱い結果はMysteryMechanismで、27モデル中27位、最下位だ。サイバーセキュリティに関しては、Mistral自身が自己申告した数字(脆弱性の再現・修正タスクで82〜93%)には、apidogのレビューアーが直接指摘した注意点が必要だ。Claude Opus 5.5とGPT-6 Astraは同じ自己申告の比較でほぼゼロ点になっているが、これはタスクを実行できないからではなく、安全性を理由にタスクを拒否しているからだ。これは純粋な能力差ではなく手法上の違いであり、Mistral自身の資料ではこの区別が明確になっていない。
Mistral Large 4対Mistral Large 3
                          Mistral Large 3        Mistral Large 4
------------------------------------------------------------------------
Total / active params      675B / 41B             ~1T-1.05T / 52B
Training hardware          3,000 Nvidia H200       3,800 Nvidia Blackwell
Released                    ~December 2025          6 October 2026
AA Intelligence Index       9                       38 (~4.2x higher)
Verbosity (output tokens     9.8M                    200M (~20x more
  to run full Index)                                  verbose)
Cost per Index task          $0.03                   $1.13 (~38x higher)

Intelligence Index, verbosity and cost figures are Artificial Analysis's
own independent measurements, not Mistral-reported.
Large 3からLarge 4への能力の飛躍は、Artificial Analysisの独立計測によれば本物で、しかも大きい。Intelligence Indexのスコアでおよそ4倍だ。だが、これには急な代償が伴う。同じ評価で出力の冗長さがおよそ20倍になり、Intelligence Indexタスク1件を実行する料金は0.03ドルから1.13ドルへ、およそ38倍に上昇した。Large 3上に構築したワークフローをアップグレードするかどうかを検討しているなら、新しく賢いモデルだからタスクあたりのコストが自動的に安くなるとは考えず、このコスト増加を明確に予算に組み込むべきだ。
オープンウェイト: 「10月末」だが未確定
Mistral自身のブログとチェンジログはどちらも、オープンウェイトは「今月末まで」または単に「近日公開」に来るとしており、具体的な日付はない。VentureBeatの報道は、開発者・サイバーセキュリティ研究者・政府当局との約3週間のテスト期間の終了という位置づけで、2026年10月27日という具体的な目標日を挙げているが、この日付はMistralの「3週間」という表現からVentureBeatが自ら推測したものであり、Mistral自身が公表した日付ではない。TechCrunchの報道はさらに曖昧で、10月6日のローンチから「わずか3週間後」としか述べていない。10月下旬という時期感は方向としては正しいと受け止めるべきだが、10月27日という具体的な日付は未確認として扱うべきだ。最終的なオープンリリースのライセンスも確定していない。VentureBeatの報道によれば、MistralはApache 2.0やMITのような標準的なライセンスではなく、独自のMistralライセンスを使う見込みだというが、これもまだ公表されておらず、現時点でのアクセスはMistralの利用規約と自己デプロイ契約によってのみ管理されている。
現時点でのアクセス方法
現時点で確認できているMistral Large 4の利用方法は、Mistral自身のAPI文書またはMistral Studioコンソール経由のみで、モデルIDはmistral-large-4だ(文書ページではmistral-large-4-0と記載されている)。TechCrunchは、現在のアクセスが「公開ガードレール付きエンドポイント」に限定されていると具体的に述べており、機密性の高いワークロードで制限のないアクセスが必要な場合は留意しておく価値がある。OpenRouter(mistralai/mistral-large-4-0として)、Eden AI、LLMGatewayといった第三者のゲートウェイにもすでに掲載されている。Mistral自身のコンシューマー向けチャットアプリ(2026年5月にLe ChatからVibeへ改称、アカウントとサブスクリプションは引き継がれている)の中でまだ利用可能になっているかどうかは確認できなかった。Mistralの発表はVibeへのリンクを掲載しているが、そこでモデルが利用できるとは明言していないため、無料で試せると思い込む前にchat.mistral.aiで直接確認すべきだ。
使うべきかどうか
- EU主権下でのホスティングやEU公式言語をまたいだ多言語作業: 妥当な適合先であり、米国・中国系ラボに対するMistralの最も明確な差別化要因の一つだ。
- 長大な法律文書やコンプライアンス文書: HarveyのLegal Agent Benchmarkでの順位(独立計測で79モデル中9位)は、絶対的なスコアは控えめであるものの、ここでの本物の強みを示唆している。
- ライブチャットやレイテンシに敏感なアプリケーション: 開始後の出力速度自体は問題ないものの、長いプロンプトでの最初のトークンまでおよそ18.7秒かかることを考えると、あまり適していない。
- 自信満々な誤答が高くつく用途全般: 独立計測による41.9%というハルシネーション率は、レビューアーの間で最も頻繁に指摘される弱点であり、出力をそのまま信頼せず検証すべきだ。
- 最先端のコーディングやレイテンシに敏感なエージェント型作業: あまり適していない。Artificial Analysis Intelligence Index(38点)は、同じくオープンウェイトである複数の中国系モデル(MiMo-V2.6-Pro 46点、GLM-5.3 45点、Qwen 3.8 Max 45.4点)に後れを取っており、コーディング用モデルを選ぶ開発者にとってはこの比較が最も重要になりやすい。
よくある質問
Mistral Large 4は無料ですか?
無料ティアは存在しない。API限定でトークン単位の課金となり、期間限定の50%オフローンチ割引(入力100万トークンあたり約0.68ドル、出力100万トークンあたり約2.09ドル)があり、Mistral自身のチェンジログによれば2026年10月6日のローンチからおよそ2週間続くとされている。
Mistral Large 4はオープンソースですか、それともオープンウェイトですか?
まだではない。Mistralはこれをオープンウェイトにする予定だと説明し、2026年「10月末まで」にウェイトを提供すると約束している。VentureBeatは10月27日という具体的だが未確認の目標日を報じている。ライセンスも確定していない。MistralはApache 2.0のような標準的なライセンスではなく、独自のライセンスを使う見込みだ。
Mistral Large 4のパラメータ数はいくつですか?
520億のアクティブパラメータで、これはMistral自身のブログと技術文書がいまや一致している数字だ。総パラメータ数は、Mistral自身の資料の間でまだ食い違いがある。ローンチブログでは1兆、技術文書では1.05兆としている。VentureBeatのローンチ当日の報道は、別途490億のアクティブパラメータを挙げているが、この数字はMistral自身の現行ページには見当たらない。
Mistral Large 4の実際のコンテキストウィンドウはどのくらいですか?
Mistralは100万トークンだとしている。独立トラッカーは実際にはそれより少ない値を計測している。Vals.aiは512,000トークンを挙げており、Artificial Analysis自身のスペック表とFAQは524,000対520,000トークンで食い違っている。
Mistral Large 4はMistral Large 3と比べてどうですか?
総パラメータ数はおよそ1.5倍で、より新しいNvidia Blackwellのハードウェア上で動作する。独立計測では、Artificial AnalysisがIntelligence Indexのスコアでおよそ4倍の飛躍(9点から38点)を計測しているが、出力の冗長さはおよそ20倍高くなり、タスクあたりの評価コストは0.03ドルから1.13ドルへ、およそ38倍に上昇している。
Mistral Large 4はハルシネーションが多いですか?
Artificial AnalysisのAA-Omniscience計測によれば、ハルシネーション率は41.9%で、独立レビューアーのeesel.aiはこれをこのモデルの最大の弱点として指摘している。特に馴染みの薄いニッチな話題については、事実に関する出力をそのまま信頼せず検証すべきだ。
Mistral Large 4が最も得意なことは何ですか?
独立計測で確認できている強みには、法律・長文文書の作業(HarveyのLegal Agent Benchmarkでの立派な順位)と、サイバーセキュリティの脆弱性再現タスクが含まれる。ただし、Mistralが自己申告しているサイバー関連のスコアには注意点が必要だ。一部の競合モデルが同じテストでほぼゼロ点になっているのは、タスクを実行できないからではなく、安全性を理由に拒否しているためだ。