Beamは5,010億パラメータのスパースなmixture-of-expertsモデル(1トークンあたりアクティブなのは230億パラメータ)で、Reflection AIが2026年10月5日に発表し、10月16日にApache 2.0ライセンスのオープンウェイトとしてリリースした。ウェイトはHugging Face上でBF16、FP8、NVFP4形式で公開されており、パブリックベータの自社API、そしてAWS、Google Cloud、Oracle、Cloudflare、OpenRouterを含む40以上のローンチパートナーが揃っている。
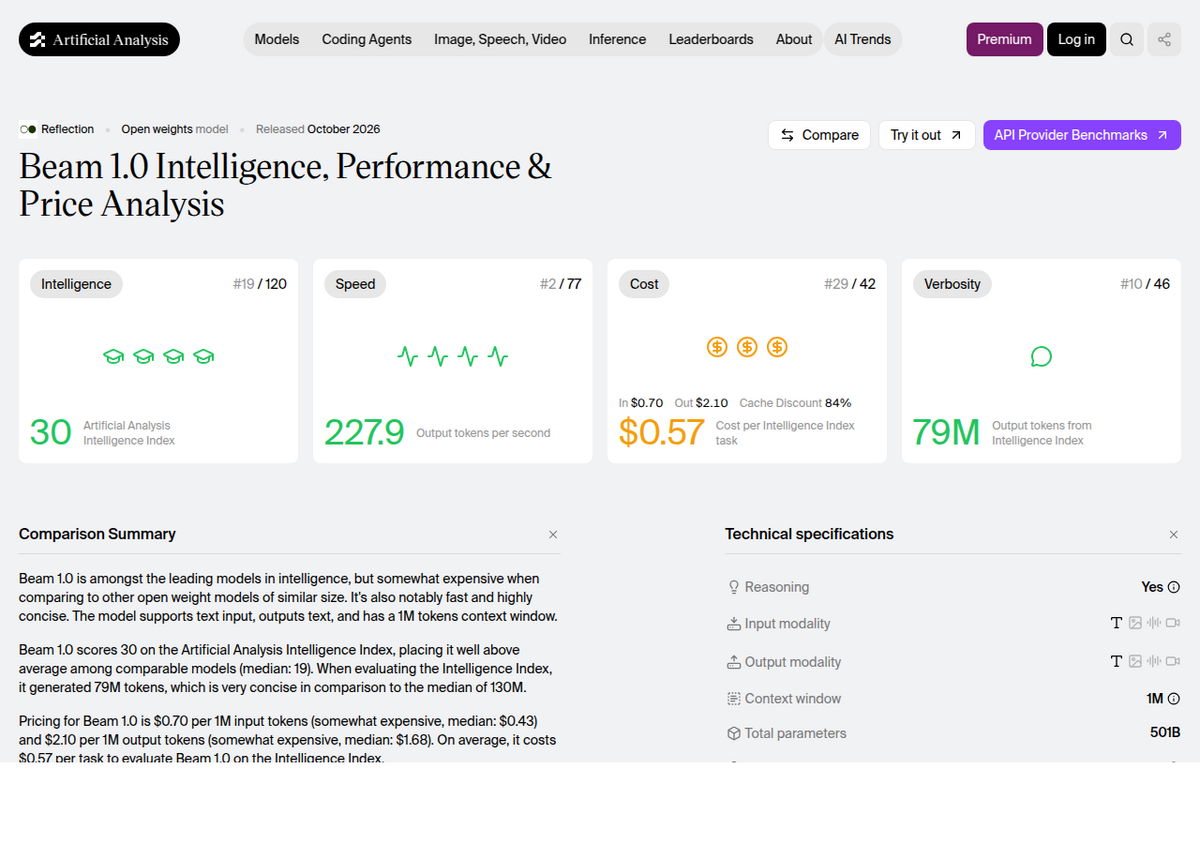
独立した評価では、Artificial AnalysisのIntelligence Indexで30点を記録している(比較対象モデルの中央値は19)。これは本稿執筆時点で追跡されている120モデル中19位に相当する。速度も速く(出力227.9トークン/秒、計測された77モデル中2位)、タスクあたりの実行コストも比較的安いが、入手可能な最強のオープンウェイトモデルというわけではない:MoonshotのKimi K3はほとんどの推論系・エージェント系ベンチマークでBeamを上回っており、Reflection自身が公開した比較表もそれを認めている。
本格的なハードウェアが必要だ。 BF16精度ではウェイトだけでおよそ1TBになり、FP8精度でも8xH200構成のノード1台程度が必要になる。ノートパソコンや単体のコンシューマー向けGPUで動かす現実的な方法はない。
2024年の「Reflection 70B」騒動とは無関係だ。 あの騒動では、別の会社がホストする「70B」モデルが、裏でひそかにClaudeへリクエストを転送していたことが判明した。Reflection AI(2024年設立、Misha Laskin氏とIoannis Antonoglou氏が創業)はこれとは無関係の会社であり、この混同は開発者フォーラムで十分頻繁に見られるため、はっきり書いておく価値がある。
Beamとは実際には何か
Beamはスパースなmixture-of-expertsモデルだ:総パラメータ数は5,010億だが、1トークンあたりに実際に活性化するのはそのうち230億だけで、ローカルとグローバルのアテンションを交互に配置した52層に分散し、エキスパート間の負荷分散にはaux-loss-free方式を使っている。入出力ともにテキスト専用で、画像生成はできず、視覚的なコンテンツについて推論できるのは、何か別のものがあらかじめそれをテキストに変換した場合に限られる。Reflection自身の発表は、これを汎用的なチャットではなく、コーディング・推論・エージェント型の作業に的を絞ったものだと説明している。
事前学習データは、Reflectionが最も多くの言葉を割いている部分だ。同社によれば、通常の生のインターネットクロールから出発し、キュレーションによってそのおよそ95%を捨て、従来のフィルターでは取りこぼしていたはずの「本当に高品質な素材」と呼ぶ約1.8兆トークンに絞り込み、それを合計23.8兆トークンの事前学習run全体に組み込んだという。コンテキストウィンドウは100万トークンだが、この数字は学習の途中段階での拡張ステップを経て到達したものであり、その後に続く強化学習フェーズ自体は25万6,000トークンに制限されている。単に長い1件の文書を扱うのではなく、非常に長いコンテキストを要するエージェント型のタスクを目的にBeamを評価しているなら、知っておく価値のある違いだ。
学習run:ほとんどのモデル発表では公開されない数字
ReflectionはBeamがどう構築されたかについて、異例なほど具体的な数字を示しており、2つの学習フェーズでは異なるハードウェアを使っている。事前学習は6,144基のNvidia GB300 NVL72 GPUで4週間未満稼働し、run後半でgoodput(GPU時間のうち実際に有用な学習進捗を生んでいた割合)92.3%に達し、勾配のスパイクやサイレントなデータ破損が疑われる事象をきっかけとする半自動の巻き戻しが9回あった。続く強化学習は別途10,500基のGB300 GPUで4週間稼働し、1億件を超えるロールアウトを生成した。そのうちおよそ8,000万件は「reasoning expert」というサブコンポーネントに特化して向けられたものだ。ピーク時には、RLのrunは平均で約11万件の並行ロールアウトを維持し、最大で17万件の並行サンドボックス、合計13億回のサンドボックス実行を、ほぼ合成データで構成された約100万個のRL環境に対して行った。ウェイトの更新は、報告によれば中央値でおよそ12秒で実際の推論基盤に反映され、このrunは学習を止めることなく71件の推論インシデントを吸収し、そのたびに中央値8分で復旧したという。
事前学習の6,144基とRLの10,500基という2つのGPU数は、第三者による別々の記事の中では、互いに矛盾しているかのように登場することがある。しかし矛盾はない:一方は事前学習用クラスタ、もう一方はその後に稼働した、はるかに大きな強化学習用クラスタだ。このローンチに関する他の報道を照らし合わせるなら、両者を混同しないよう注意する価値がある。
発表は10月5日、実際のリリースは10月16日
これが、Beamに関する既存報道の多くが古くなってしまっている部分だ。その多くがこの空白期間中に書かれたからだ。Reflectionの10月5日の発表は、ウェイティングリストのみによる早期アクセスを開始したにすぎず、同社はウェイト、技術レポート、開発者向けツールは、モデルが最終的なセキュリティチェックと説明するものを終えた後、「今後数週間で」提供すると述べていた。その11日後、Reflectionは2026年10月16日付の2本目の記事「Beam is now available」を公開し、正式リリースを確認した:Hugging Face上のオープンウェイト(BF16、FP8、NVFP4形式に加え、別途投機的デコード用のドラフターモデル)、確定したApache 2.0ライセンス、「無料で始められる」と説明されているplatform.reflection.aiでのパブリックベータの自社API、そして複数の教師モデルによるオンポリシー蒸留を用いた安全性トレーニングの手法を扱う安全性技術レポートだ。
このリリースには、すでに接続済みの40以上のローンチパートナーも伴っていた:クラウドプラットフォーム(AWS、Google Cloud、Microsoft Foundry、Oracle、Cloudflare、CoreWeave、Databricks)、推論マーケットプレイス(Together AI、OpenRouter、Baseten、Fireworks、Nebius、Modal)、Nvidia自身のNIMマイクロサービス、ローカル推論ツール(Ollama、LM Studio)、オンプレミスおよびソブリン/エアギャップ環境向けの導入パートナー(Dell、HPE)、そして開発者が実際に使っているオープンソースのサービングスタック(Transformers、vLLM、SGLang、Unsloth、Axolotl)での発売当日からの対応だ。Vercelはローンチ期間中、自社のAI Gatewayでこれを無料で動かした。わずか2週間前の発表にしては本当に幅広い配布の後押しであり、他の場所でこのモデルについて言及する際には、10月5日のティーザーではなく10月16日のリリースを本当のローンチ日として扱うべき、最大の理由だ。
ベンチマーク:独立した評価とReflection自身の比較表
ベンダーの自己申告スコアではなく、すべてのモデルを同一の標準化されたIntelligence Indexに通して評価しているArtificial Analysisは、Beamを30点としており、これはカテゴリ内の中央値19に対して、追跡対象120モデル中19位に相当する。中央値を確実に上回る、しっかりした結果だ。また目立って速く(出力227.9トークン/秒、計測された77モデル中2位)、比較的簡潔でもある(Index全体の実行に7,900万トークン、中央値の1億3,000万トークンに対して)。これにより、1トークンあたりの料金(100万トークンあたり入力0.70ドル、出力2.10ドル)はArtificial Analysis自身が業界内で「やや高め」と評しているにもかかわらず、タスクあたりのコストは0.57ドルに抑えられている。
Benchmark (Reflection's own table,      Beam    GLM-5.2   Kimi K3   Qwen 3.8   DeepSeek
updated 8 Oct 2026)                                                    Max       V4.1 Flash
-----------------------------------------------------------------------------------------
SWE-Bench Pro v1                        65.5     62.1       NR       67.7        NR
Terminal-Bench v2.1                     80.1     81.0      88.3      86.6       90.6
DeepSWE v1.1                            44.4     44.0      68.0      51.0       74.2
GPQA Diamond                            90.5     91.2      93.5      92.6       90.9
tau3 banking (agentic tool use)         38.0     37.1      37.1      55.2         NR
BrowseComp                              77.4       NR      91.2        NR         NR
HLE, no tools                           36.2     40.5      46.9      43.6       39.1

Figures are Reflection AI's own published comparison table. NR means
Reflection didn't report that model on that benchmark.
SWE-bench Verified (Beam: 80.9) is omitted here because Reflection's table
only compares it against two other models on that specific benchmark, not
this set.この表はReflection自身が位置づけている通りに読む価値がある。同社はBeamが劣っている点について率直だからだ。その目玉となる主張は、Beamが高度な推論においてZ.aiのGLM-5.2とおおむね同等の性能を、3〜4倍少ない推論計算量で達成しているというものだが、Reflectionはこれを(サードパーティのトークン数を使い、2×アクティブパラメータ数×平均生成トークン数として算出した)明示的な推定値であり、計測されたドル単位のコストではないとしている。比較対象もGLM-5.2であって、Z.aiのより新しいGLM-5.3ではなく、GLM-5.3は上の表のほぼすべての行でBeamより高いスコアを記録している。そしてReflectionは、何の留保もなくMoonshotのKimi K3が生の能力では優れていると直接述べている:Kimi K3は2.8兆パラメータのネイティブなマルチモーダルモデルで、Artificial AnalysisのIntelligence Indexはおよそ57、Claude Opus 5.5とほぼ同水準で、Beamの30を大きく上回る。Beamの売りは効率性と米国産であることであり、正面対決での能力勝負ではない。
Beamを事実に関する何かのために信用する前に指摘しておく価値のある数字がある:あるモデルがどれだけの頻度で自信満々に間違った内容を述べるかを測るArtificial AnalysisのAA-Omniscienceベンチマークで、Beamの幻覚(ハルシネーション)率はおよそ47%に達し、同じテストでの正答率はおよそ33%にとどまる。これは研究や引用を多用する作業に望ましい比率より明らかに悪く、Beam単体の事実に関する主張を信用するよりも、(Gemini Notebookがネイティブに行っているような)検索やソースに基づくグラウンディングと組み合わせるべき良い根拠になる。
Beamは本当に「西側」トップのオープンウェイトモデルなのか?実はそうではない
ローンチ週に出た複数の記事は、同じ時期に他に何がリリースされていたかを確認せずに、Beamを中国製のオープンウェイト系ラボに対する米国製の最有力回答として位置づけていた。Artificial Analysis自身のIntelligence Indexでは、Meta自身のMuse Model Licenseの下でリリースされた8,160億パラメータのオープンウェイトモデル(アクティブ420億)であるMetaのMuse Spark Openが39点を記録しており、Beamの30点を上回っている。この指標で見る限り、Beamは1位ではなく2位の米国原産オープンウェイトモデルだ。(Muse Spark Openは、Metaが同じ月にリリースしたクローズドなフロンティアモデルであるMetaのMuse Wonderとは別のモデルだ。「Muse」というブランド名を共有しているため混同しやすいが、一方はオープンウェイトで、もう一方はそうではない。)小さな訂正ではあるが、ベンチマークのスコアよりも出自を理由にモデルを選んでいるなら、正確に押さえておく価値のある点だ。
実際に自分で動かせるのか
ノートパソコンでは無理で、単体のコンシューマー向けGPUでも無理だ。Beamはmixture-of-expertsモデルなので、5,010億パラメータのうち1トークンあたりに活性化するのは230億だけで、これが推論の計算量を抑えてくれるが、どのリクエストでどのエキスパートが活性化するかに関わらず、5,010億パラメータすべてがメモリ上に常駐していなければならない。フルBF16精度ではウェイトのメモリ使用量はおよそ1TB、FP8またはINT8ではおよそ500〜600GBまで下がり、最も積極的なNVFP4/INT4量子化でもおよそ250〜360GB程度になる。セルフホスティングの実用上の最低条件は、FP8で動かす単体の8xH200(GPU1基あたり141GB)ノード、あるいはテンソル並列とパイプライン並列に分割した2台の8xH100(80GB)ノードだ。これはホビー向けではなくデータセンター級のモデルであり、自宅で動かす方法を探す前に知っておく価値がある。
ホスティングではなく利用だけしたいなら、料金はプロバイダーによってかなり差がある:OpenRouterは100万トークンあたり入力0.25ドル/出力1.00ドル程度を掲載しているのに対し、Artificial Analysis自身が計測したプロバイダー横断の中央値は0.70ドル/2.10ドルに近い。ここに示した数字は固定料金ではなくあくまで一時点のスナップショットとして扱い、実際に使うプロバイダーで最新の料金を確認してほしい。Beamは40以上のホスティングパートナーとともにローンチし、料金設定はパートナーごとに統一されていない。
開発者たちは実際に何と言っているか
Beamの最初の発表に関するHacker Newsのスレッド(556ポイント、コメント173件)は、現場の空気をつかむのに有用で、ほぼすべてが10月16日のリリース前に書き込まれている。最も支持を集めた実質的な批判は、BeamをDeepSeekのV4.1 Flashと直接比較するものだった:あるコメント投稿者は、Beamは「DeepSeek v4.1 Flashより大きく、動かすのに費用がかかり、計測されたすべての指標で劣っているように見える」と書いており、この主張は上のベンチマーク表でも、特にエージェント型とコーディング系のタスクに関して部分的に裏付けられている。まだウェイトが伴っていない発表にはありがちなテーマとして、「話は簡単だ、ウェイトを見せてくれ」という趣旨の意見が繰り返し見られ、オープンを売りにしながら実際のリリースを制限するべきではないという鋭い反発もあった。他のスレッドでは本当に実用的な議論も扱われていた:4bit量子化でBeamをローカルで動かすには128GBの統合メモリマシン2台程度が必要になるという推定や、一部の競合モデルにはある視覚対応がBeamにはないという指摘だ。議論の中で繰り返し見られた別の論点は、「中国系ラボに対する西側の代替」という枠組み自体への懐疑であり、一部のコメント投稿者は、ベンチマークの数字よりも出身国というアピールの方が働いていると主張していた。
r/LocalLLaMAでは、報道によれば、ウェイトがまだ公開されていなかったことを理由に、10月5日の最初の発表スレッドがサブレディットのvaporware禁止ルール違反としてモデレーターにより削除されたという。ベンチマーク、その後実際のウェイトが登場した後は、そこでより一般的だった見方は、BeamはおおむねGLM-5.2と同じくらいの位置にあり、本気で使うユーザーにとっての主な魅力は、純粋な能力で最強の選択肢であることではなく、それが特に重要になる導入先でのデータの主権と非中国産であることだ、というものだった。
使うべきかどうか
- 主権が重視される導入先(政府機関、規制の厳しい企業、エアギャップ環境)向けに、非中国製で本当にオープンウェイトなモデルが必要:相性が良く、おそらくBeamの最も明確な差別化要因でもある。DellとHPEがすでにオンプレミスパートナーとして体制を整えている。
- 純粋に能力だけでオープンウェイトモデルを選びたい:相性は弱い。Reflection自身が公開した数字でも、生の推論とエージェント型ベンチマークではKimi K3がリードしており、Artificial AnalysisのIntelligence IndexではMetaのMuse Spark Openの方が高いスコアを記録している。
- 自分のハードウェアでセルフホストしたい:データセンター級のGPU(最低でもおよそ8xH200ノード1台)がなければ現実的ではない。コンシューマー向けハードウェアでは選択肢にならない。
- 研究や引用を多用する作業で事実としての信頼性が必要:単体では相性が弱い。AA-Omniscienceでのおよそ47%という幻覚率は本物の弱点であり、単独の回答を信用するのではなく、検索やソースに基づくグラウンディングと組み合わせるべきだ。
- 高速で比較的安価なエージェント型コーディングの実行がしたく、絶対的な最上位層に劣ることは許容できる:妥当な相性だ。出力速度は77モデル中2位、Intelligence Indexタスクあたりのコストも中央値以下だ。
よくある質問
Reflection AIのBeamは実際にオープンソースですか?
完全なオープンソースではなく、オープンウェイトだ。ウェイト、トークナイザー、参考実装はApache 2.0のもとで公開されており、2026年10月16日のリリース時に同社が確認している。学習データと完全な学習コードは公開されていない。これは大規模モデルにおける「オープンウェイト」と「オープンソース」の標準的な区別だ。
Beamを自分のパソコンで動かせますか?
コンシューマー向けGPUやノートパソコンでは動かせない。最も積極的な量子化(NVFP4/INT4)でも、1トークンあたり何個が活性化するかに関わらず5,010億パラメータすべてが常駐する必要があるため、モデル全体でおよそ250〜360GBのメモリが必要になる。現実的な最低条件は、データセンター向けの8xH200ノード1台だ。
BeamはDeepSeek、Qwen、Kimi K3より優れていますか?
生の能力では優れていない。Reflection自身が公開したベンチマーク表では、ほとんどのエージェント型・コーディング系ベンチマーク(Terminal-Bench、DeepSWE、BrowseComp)でKimi K3とDeepSeek V4.1 FlashがBeamを上回っている。Beamの売りは推論効率と米国/非中国産であることであり、スコアでの正面対決での勝利ではない。
これは2024年に偽ベンチマーク騒動を起こした「Reflection」と同じ会社ですか?
いいえ。あれは別の会社、Matt Shumer氏のHyperWriteで、同社がホストする「Reflection 70B」モデルは、主張していたモデルを動かしているのではなく、実際にはClaudeへリクエストを転送していたことが判明した。Reflection AIは、2024年に元Google DeepMindの研究者Misha Laskin氏とIoannis Antonoglou氏が設立し、Nvidia、Sequoia、Lightspeedの支援を受けている、これとは無関係の会社だ。
Beamのウェイトは実際にいつリリースされましたか?
Reflectionは2026年10月5日にBeamを発表したが、その時点ではウェイティングリストのみによる早期アクセスだった。完全なオープンウェイト、技術・安全性レポート、パートナー連携が公開されたのは、約2週間後の2026年10月16日だ。ローンチ週の報道の多くは、この空白期間よりも前に書かれている。
Beamは中国以外で作られたオープンウェイトモデルの中で最高ですか?
Artificial Analysis自身のIntelligence Indexでは違う。Meta自身のライセンスのもとでリリースされた8,160億パラメータのオープンウェイトモデルであるMeta Muse Spark Openは、同じ独立したベンチマークでBeamの30点に対して39点を記録しており、Beamは1位ではなく2位の米国原産オープンウェイトモデルということになる。