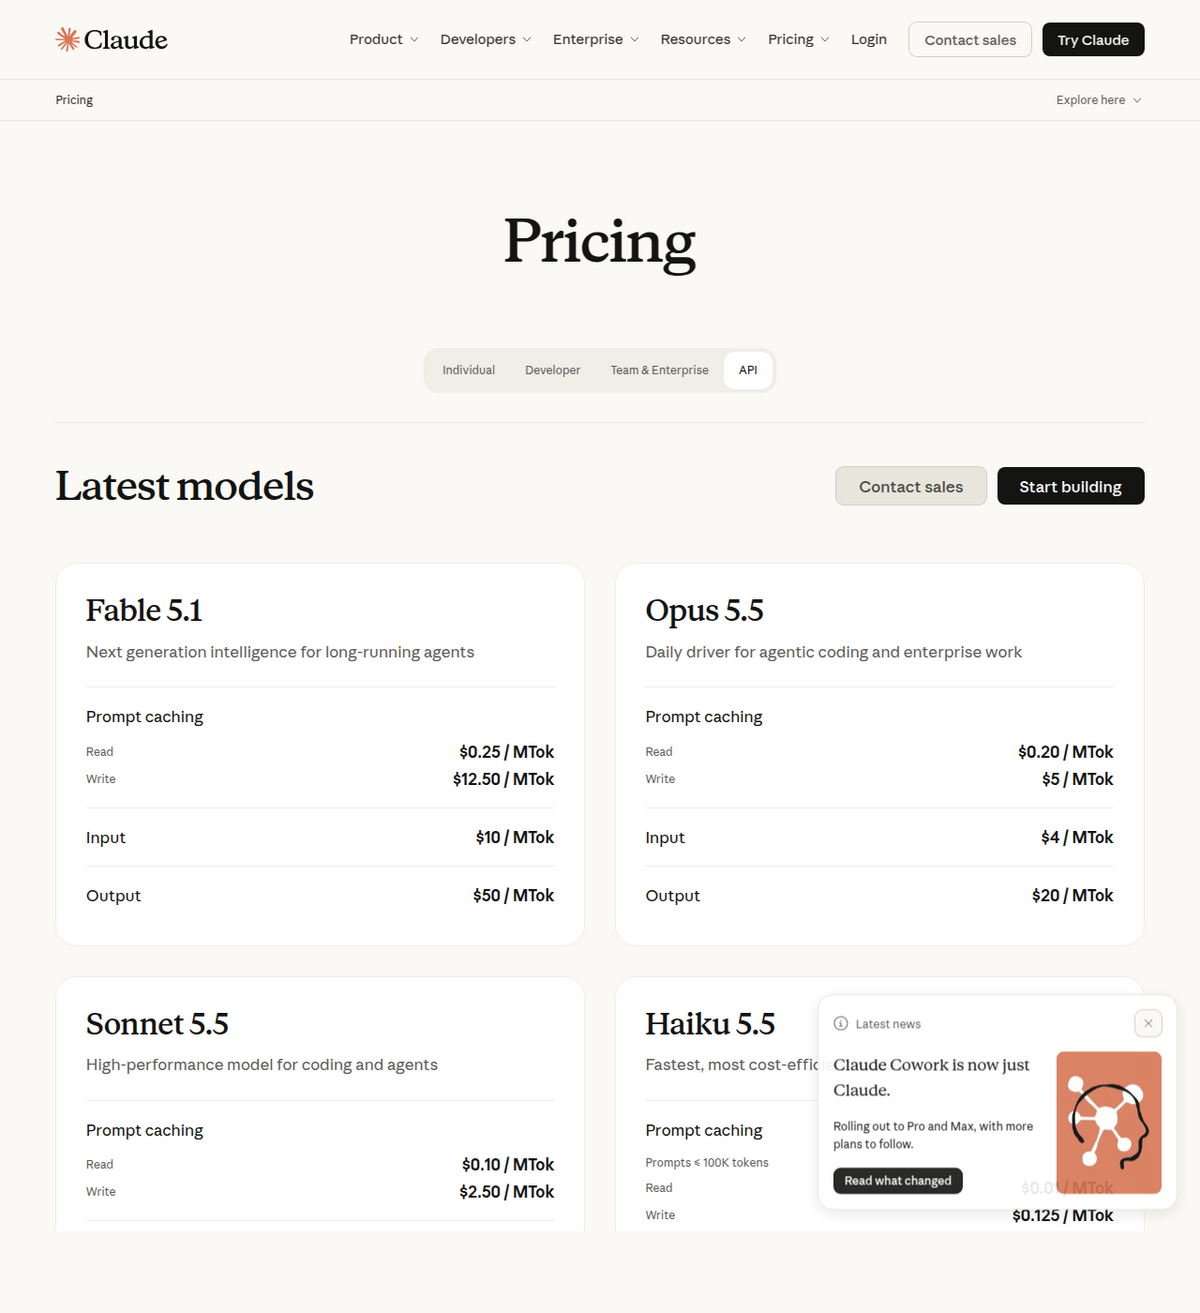
O Claude Sonnet 5.5 foi lançado em 28 de setembro de 2026, o segundo lançamento da renovação "5.5" da Anthropic, seis dias depois do Opus 5.5 (22 de setembro). O preço não mudou em relação ao Sonnet 5: US$ 2 por milhão de tokens de entrada, US$ 10 por milhão de tokens de saída. O único preço que realmente mudou é fácil de não perceber: as leituras de cache de prompt caíram para US$ 0,10 por milhão de tokens, a metade da antiga taxa de US$ 0,20 do Sonnet 5. A maioria dos rastreadores de preço de terceiros que verificamos ainda lista US$ 0,20 como valor atual.
Em benchmarks de trabalho de conhecimento e uso de computador, é quase um empate com o Opus 5.5 pela metade do preço. O Sonnet 5.5 marca 1844 no GDPval-AA v2.1 contra os 1846 do Opus, e 80,1% no OSWorld 2.1 contra os 81,8% do Opus, diferenças de um a dois pontos apesar do preço 2x menor.
O próprio número da Anthropic e o reteste de um laboratório independente não coincidem. A Anthropic relata 70,6% no Terminal-Bench 4.0; o reteste independente da Artificial Analysis no mesmo benchmark obteve 64%, ainda na frente dos 60% do Opus 5.5 na mesma plataforma de teste, mas uma diferença real entre o número de marketing e os resultados reproduzidos que vale conhecer antes de planejar algo em torno dela.
A alegação de "até 30% mais barato" não se sustenta em toda configuração. No esforço máximo de raciocínio, o Sonnet 5.5 gera em média cerca de 193.000 tokens de saída por tarefa, o maior número que a Artificial Analysis já mediu para qualquer modelo, o que empurra seu custo por tarefa para cerca de US$ 7,60, mais alto que o Sonnet 5 e, em uma medição, mais alto que o Opus 5.5 atingindo a mesma qualidade com tokens mais caros e em menor número.
O que foi lançado, e em que ordem
O nosso próprio guia do Opus 5.5 afirmava a ordem contrária até corrigirmos isso durante a pesquisa para este texto. A própria documentação de modelos da Anthropic lista o lançamento do Opus 5.5 em 22 de setembro de 2026 e o do Sonnet 5.5 em 28 de setembro de 2026, seis dias depois, não antes. A ordem importa para como interpretar a comparação: o Sonnet 5.5 é o ato seguinte, que já tinha os números de benchmark do Opus 5.5 para superar, não o aquecimento antes dele.
O ID do modelo na API é claude-sonnet-5-5, disponível pela API da Claude, Amazon Bedrock, Google Cloud Vertex AI e Microsoft Foundry. A janela de contexto continua em 1 milhão de tokens, com limite de saída de 128K tokens em requisições padrão, extensível a 300K tokens na Batch API por trás de um cabeçalho beta output-300k-2026-03-24. A data de corte de conhecimento é junho de 2026, tanto para treinamento quanto para fins de recall confiável. Um padrão de comportamento mudou em relação ao Sonnet 5: o Sonnet 5.5 raciocina por padrão em esforço alto (o Opus 5.5 usa médio como padrão), e sua configuração manual de raciocínio mais baixa agora é between_tools em vez da antiga opção disabled, uma mudança que quebra integrações que desativavam o raciocínio explicitamente.
A pegadinha do preço: as leituras de cache ficaram mais baratas, e a maioria dos rastreadores não percebeu
O preço de entrada e saída permaneceu inalterado em relação ao Sonnet 5: US$ 2 por milhão de tokens de entrada, US$ 10 de saída. O cache de prompt é onde algo realmente mudou. A documentação da Anthropic afirma que o Sonnet 5.5 mantém os mesmos preços do Sonnet 5, "exceto para leituras de cache de prompt, que custam US$ 0,10 por milhão de tokens, a metade da taxa do Claude Sonnet 5." As escritas de cache continuam em US$ 2,50/milhão para um cache de 5 minutos e US$ 4/milhão para um cache de 1 hora. A Batch API ainda aplica um desconto de 50% sobre entrada e saída, efetivamente US$ 1/US$ 5 por milhão de tokens para cargas de trabalho assíncronas.
Verificamos vários resumos de preços publicados depois do lançamento do Sonnet 5.5, e mais de um, incluindo o guia de preços do eesel.ai, ainda lista as leituras de cache a US$ 0,20, o valor antigo do Sonnet 5, em vez do valor corrigido de US$ 0,10. Se você está orçando uma carga de trabalho com alta taxa de acerto de cache, a diferença se acumula: uma carga de trabalho que lê majoritariamente do cache custa aproximadamente a metade do que uma tabela desatualizada sugeriria. Confira qualquer alegação de preço diretamente na documentação da Anthropic, em vez de numa tabela secundária, incluindo esta aqui, antes de comprometer um orçamento com base nela.
Benchmarks: um quase-empate com o Opus, com uma diferença entre o fornecedor e um laboratório independente
Benchmark                    Sonnet 5.5   Opus 5.5   Sonnet 5
----------------------------------------------------------------
GDPval-AA v2.1 (knowledge work)    1844         1846        1449
OSWorld 2.1 (partial credit)       80.1%        81.8%       57.0%
OSWorld 2.1 (strict pass)          43.5%        48.7%       25.6%
Terminal-Bench 4.0 (Anthropic)     70.6%        66.4%       10.3%
Terminal-Bench 4.0 (AA re-test)      64%          60%          -
FrontierCode 1.1 (xhigh effort)    52.1%        54.4%       42.4%
CursorBench 4.0                    55.5%        57.8%       34.1%
Humanity's Last Exam (w/ tools)    64.5%        67.7%       54.9%

AA = Artificial Analysis, an independent benchmark lab.
Terminal-Bench shows the largest vendor-vs-independent gap of
any figure checked for this article.
No GDPval-AA, um benchmark de trabalho de conhecimento, e no OSWorld, um teste de operar um computador real através de uma interface gráfica, o Sonnet 5.5 fica entre um e dois pontos do Opus 5.5 apesar de custar a metade. Essa é a manchete que a maioria das coberturas destaca, e é precisa. O que a maioria das coberturas deixa de mencionar é a divisão do OSWorld: o número de 80,1% é crédito parcial, que recompensa o progresso em direção a uma tarefa mesmo que ela não seja totalmente concluída. A taxa de aprovação estrita, só contando a conclusão total da tarefa, é de 43,5% para o Sonnet 5.5 contra 48,7% para o Opus 5.5, uma diferença que se amplia de 1,7 ponto no crédito parcial para 5,2 pontos na aprovação estrita, um número bem diferente para planejar se o seu caso de uso exige uma tarefa concluída em vez de majoritariamente concluída.
A diferença no Terminal-Bench merece ser destacada por si só. O material de lançamento da Anthropic relata 70,6% para o Sonnet 5.5. A Artificial Analysis, um laboratório independente que reexecuta benchmarks na própria plataforma de teste em vez de aceitar os números do fornecedor sem verificação, mediu 64%, uma queda de seis pontos em relação ao número do fornecedor, embora ainda na frente dos 60% do Opus 5.5 na mesma plataforma. Nenhum dos dois números está exatamente errado; eles refletem condições de teste diferentes. Mas uma diferença de seis pontos entre o que uma empresa relata e o que um terceiro independente reproduz é o tipo de detalhe que pertence a qualquer comparação séria, e esteve praticamente ausente nas páginas de concorrentes que verificamos.
Uma thread no Hacker News discutindo o lançamento (884 pontos, 613 comentários) levantou uma ressalva relacionada: parte da liderança do Sonnet 5.5 sobre o Opus 5.5 em alguns benchmarks agênticos pode refletir o comportamento de roteamento de segurança do Opus, e não uma diferença pura de capacidade. Um comentarista citou o Opus 5.5 recuando para um modelo mais fraco em cerca de 10% das tentativas por conta de disparos de salvaguarda, bem acima da taxa de recuo do Sonnet nos mesmos testes. Isso é uma observação da comunidade, não um número confirmado pela Anthropic, mas é uma explicação plausível para o fato de um modelo mais barato continuar quase igualando ou superando um mais caro em testes específicos.
A verdadeira história de custo: verbosidade de tokens no esforço máximo
A Anthropic divulga o Sonnet 5.5 como capaz de entregar tarefas com até 30% menos custo que o Sonnet 5. Essa alegação é real para a combinação de tarefas e o nível de esforço escolhidos pela Anthropic, mas não se sustenta de forma universal, e essa diferença é o fato isolado mais útil deste artigo para quem de fato paga a conta. A Artificial Analysis mediu o Sonnet 5.5 gerando em média cerca de 193.000 tokens de saída por tarefa no esforço máximo de raciocínio, o maior número que a AA já registrou para qualquer modelo que acompanha, cerca de 60% mais que o Opus 5.5 ou o Sonnet 5 na mesma configuração de esforço máximo, e aproximadamente sete vezes a verbosidade do GPT-6 Astra em tarefas comparáveis.
Essa verbosidade aparece diretamente no custo por tarefa: a AA mediu o Sonnet 5.5 em cerca de US$ 7,60 por tarefa no esforço máximo, cerca de 50% mais alto que o custo do Sonnet 5 na mesma configuração. Em uma comparação da AA, o Opus 5.5 atingiu a pontuação de qualidade máxima do Sonnet 5.5 por cerca de US$ 3,46 por tarefa, precisando de tokens mais caros e em menor número em vez de muitos mais baratos para chegar lá, mais barato no total que a própria execução do Sonnet 5.5 no esforço máximo. A lição prática: a vantagem de preço do Sonnet 5.5 é real na sua configuração padrão de esforço alto para tarefas bem delimitadas, e pode desaparecer ou se inverter se você o levar ao esforço máximo em algo genuinamente difícil, onde os tokens mais caros e em menor número do Opus 5.5 às vezes terminam o trabalho por menos.
Sonnet 5.5 vs Opus 5.5: o que a própria Anthropic diz para você comprar
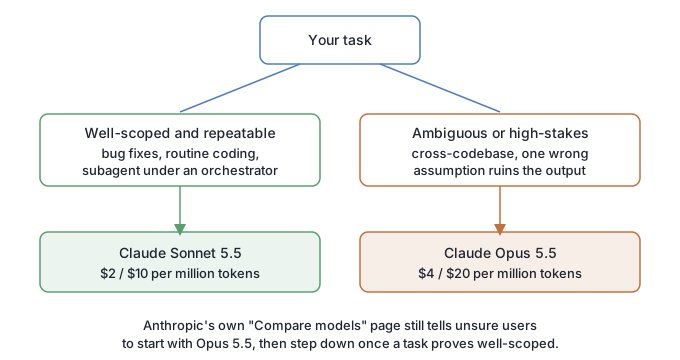
A Anthropic não posiciona o Sonnet 5.5 como substituto do Opus 5.5. O próprio anúncio chama o Sonnet 5.5 de "um complemento mais rápido e de menor custo para o Claude Opus 5.5", reservando o Opus para "trabalho complexo que exige julgamento cuidadoso". A tabela de comparação de modelos da documentação é ainda mais direta: ela diz a usuários indecisos para começar com o Opus 5.5 na maioria das cargas de trabalho, e trata o Sonnet como o modelo para o qual você desce depois de já saber que uma tarefa está bem delimitada, não como a escolha padrão.
Há uma troca real de precisão por trás dessa orientação que as tabelas de benchmark não mostram diretamente. No teste Omniscience da Artificial Analysis, uma medida de precisão factual, o Opus 5.5 pontua 66% contra 54% do Sonnet 5.5, o Opus simplesmente sabe mais fatos corretos. Mas na taxa de alucinação, o Sonnet 5.5 é na verdade menor (melhor), com 47% contra 59% do Opus: quando o Sonnet 5.5 não sabe algo, é mais provável que ele admita em vez de arriscar um palpite, mesmo tendo menos conhecimento no total. Para síntese de pesquisa especificamente, uma taxa de alucinação menor no que ele de fato tenta responder pode importar mais que um teto de conhecimento bruto mais alto, dependendo se você prefere pegar uma lacuna ou pegar uma resposta errada afirmada com confiança.
A reclamação que domina a discussão entre desenvolvedores: salvaguardas bloqueando trabalho comum
O tema recorrente mais forte naquela thread do Hacker News não era preço nem benchmarks, era o sistema de salvaguarda cibernética da Anthropic marcando trabalho legítimo como arriscado. Desenvolvedores relataram ser bloqueados ou redirecionados para um modo restrito em tarefas como firmware Bluetooth de ESP32, revisão de código C antigo, implementações de write-ahead-log, e pesquisa autorizada de bug bounty. O resumo de um comentarista, "eu não quero uma ferramenta de babá", foi repetido várias vezes na thread, junto com queixas de que o "Cyber Verification Program" por trás disso produz falsos positivos sem um caminho claro de recurso.
Um segundo grupo de reclamações girava em torno de limites de uso, não de roteamento de segurança: vários usuários relataram esgotar as cotas do plano Max bem antes de o período de faturamento renovar, um citando um plano Opus 5.5 20x consumido em quatro de sete dias, e um relato separado de uma equipe atingindo um orçamento mensal de US$ 10.000 em tokens em menos de um dia de uso agêntico intenso. Nenhuma das duas reclamações é específica das capacidades do Sonnet 5.5, mas ambas afetam o custo prático de adotá-lo dentro de um fluxo de trabalho agêntico, e nenhuma aparece num gráfico de benchmark.
Uma comparação feita de forma independente dá uma noção mais concreta da confiabilidade no mundo real. A plataforma de revisão de código CodeRabbit testou o Sonnet 5.5 contra o Sonnet 5 em 13 pull requests com bugs conhecidos e previamente catalogados: o Sonnet 5.5 pegou 6 de 13 contra os 4 de 13 do Sonnet 5, a um custo por revisão cerca de 60% menor e aproximadamente metade da latência (média de 5 minutos e 27 segundos contra 9 minutos e 55 segundos). O Opus 5.5 ainda pegou mais, de 8 a 10 dos mesmos 13 bugs dependendo da execução. Isso combina com o padrão que o próprio posicionamento da Anthropic descreve: o Sonnet 5.5 é uma melhoria real sobre o Sonnet 5 pelo mesmo preço, e o Opus 5.5 continua pegando mais nos casos que mais importam.
Sonnet 5.5 contra o mercado: GPT-6 Sol e o problema de Pareto
O GPT-6 Sol da OpenAI tem preço idêntico ao do Sonnet 5.5, US$ 2/US$ 10 por milhão de tokens, o que torna os dois um confronto direto em custo. O Sonnet 5.5 lidera claramente no GDPval-AA (1844 contra 1487) e no AA-Briefcase (1811 contra 1483), e fica ligeiramente na frente no FrontierCode (52,1% contra 49,3%). Mas a Artificial Analysis observa que o Sonnet 5.5 fica fora da fronteira de inteligência por token de saída no mesmo preço, por causa do mesmo problema de verbosidade descrito acima: o GPT-6 Sol entrega mais capacidade medida por token de saída a um preço comparável, mesmo quando o Sonnet 5.5 vence nas pontuações brutas de benchmark. Qual dos dois sai mais barato em produção depende muito de quanta verbosidade a sua carga de trabalho específica permite a um modelo, não só da tabela de benchmark que vira manchete.
Quem deveria realmente usar o Sonnet 5.5
- Use o Sonnet 5.5 se sua carga de trabalho é bem delimitada e repetível: codificação de rotina, correções de bugs com um caso de reprodução claro, ou um subagente rodando sob um orquestrador de nível Opus. É aqui que suas pontuações de benchmark quase no nível do Opus pela metade do preço realmente compensam.
- Use o Sonnet 5.5 se você já estava no Sonnet 5 e não mudou nada. A atualização é efetivamente gratuita no alias de modelo
sonnet, e testes independentes (a comparação de revisão de PR da CodeRabbit, um teste separado de agente de edição na prática) mostram um salto real de qualidade pelo mesmo preço. - Suba para o Opus 5.5 se a tarefa for ambígua, abranger uma base de código desconhecida, ou se uma única suposição errada custar caro. A vantagem do Opus sobre o Sonnet se amplia exatamente nesses casos mais difíceis e menos delimitados.
- Não dê por certo o "até 30% mais barato" no esforço máximo. Se você está levando o Sonnet 5.5 à sua configuração de raciocínio mais alta em problemas genuinamente difíceis, confira o gasto real de tokens. Medições independentes constataram que pode custar mais que o Sonnet 5, e por vezes mais que o Opus 5.5 chegando ao mesmo resultado.
- Orce cargas de trabalho intensas em cache usando US$ 0,10/milhão para leituras, não o valor de US$ 0,20 que vários rastreadores de preço ainda publicam.
As pessoas também perguntam
Quando o Claude Sonnet 5.5 foi lançado, e antes ou depois do Opus 5.5?
Em 28 de setembro de 2026, seis dias depois do Claude Opus 5.5 (22 de setembro de 2026), não antes. Uma versão anterior do nosso próprio guia do Opus 5.5 tinha a ordem invertida; corrigimos depois de verificar na própria documentação da Anthropic.
Quanto custa o Claude Sonnet 5.5?
US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, sem mudança em relação ao Sonnet 5. As leituras de cache de prompt custam US$ 0,10 por milhão de tokens, a metade da antiga taxa de US$ 0,20 do Sonnet 5, uma mudança que vários rastreadores de preço de terceiros ainda não atualizaram. A Batch API aplica um desconto de 50% sobre o preço padrão.
O Claude Sonnet 5.5 é tão bom quanto o Opus 5.5?
No GDPval-AA (trabalho de conhecimento) e no OSWorld (uso de computador), o Sonnet 5.5 pontua entre um e dois pontos do Opus 5.5 apesar de custar a metade. O Opus 5.5 se destaca em benchmarks mais difíceis e menos delimitados e em precisão factual (66% contra 54% no AA-Omniscience), enquanto o Sonnet 5.5 na verdade alucina menos quando não sabe uma resposta (47% contra 59%).
O Claude Sonnet 5.5 é realmente até 30% mais barato que o Sonnet 5?
Na combinação de tarefas e no nível de esforço padrão escolhidos pela Anthropic, sim. No esforço máximo de raciocínio, testes independentes constataram que o Sonnet 5.5 gera muito mais tokens de saída por tarefa que o Sonnet 5, elevando seu custo por tarefa em cerca de 50% nessa configuração, e por vezes mais alto que o Opus 5.5 chegando à mesma qualidade com menos tokens.
Por que as pessoas reclamam das salvaguardas cibernéticas da Claude no Sonnet e no Opus 5.5?
Desenvolvedores relataram trabalho legítimo, código de firmware, revisão de C antigo, pesquisa de segurança autorizada, sendo marcado ou restringido pelo Cyber Verification Program da Anthropic. A reclamação não é sobre uma resposta errada específica; é sobre falsos positivos interrompendo o trabalho comum de desenvolvimento sem um caminho claro para resolver.