O Qwen3.8 Max pontua mais alto no Intelligence Index da Artificial Analysis (45 vs. 36), mas custa cerca de 70% mais e gera saída a menos da metade da velocidade do DeepSeek (42 vs. 99 tokens por segundo), segundo o comparativo direto e atual da Artificial Analysis, verificado hoje.
Os pesos do DeepSeek V4 Pro têm licença MIT e são baixáveis. A API hospedada do Qwen3.8 Max é proprietária, e até o checkpoint de peso aberto lançado separadamente por trás dela carrega uma licença customizada e não-Apache, com um gatilho de receita comercial, não a licença permissiva pela qual os modelos menores da Qwen são conhecidos.
Em codificação agêntica e uso de terminal, a DeepSeek é competitiva ou está na frente: ela supera ligeiramente a Qwen no SciCode e perde de forma acentuada no Terminal-Bench 4.0 (14% vs. 39%). A Qwen lidera conhecimento geral e benchmarks de trabalho agêntico de conhecimento por uma margem ampla.
A DeepSeek tem um desconto embutido fora de pico, com entrada e saída cerca de 50% mais baratas, que se aplica por padrão na maior parte da semana; o preço cheio só entra em vigor em dois blocos estreitos de dias úteis em horário UTC. O preço da Qwen é fixo durante o dia todo.
Os flagships, em outubro de 2026
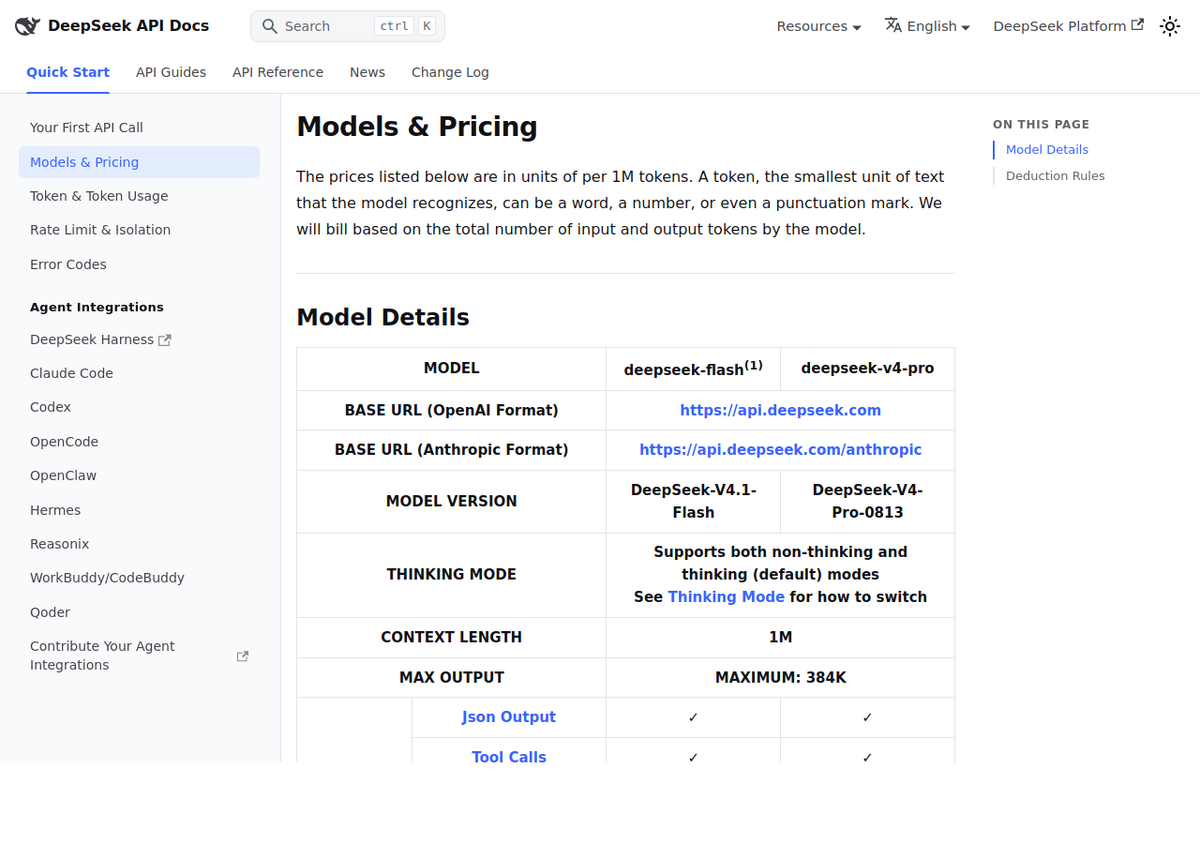
As duas empresas lançam modelos sob números de versão que mudam com frequência suficiente para confundir os resultados de busca, então vale a pena ser preciso sobre qual build esta comparação cobre. DeepSeek-V4-Pro-0813 é o lançamento de disponibilidade geral que a própria documentação da API da DeepSeek lista hoje, datado pelo seu sufixo de versão em 13 de agosto de 2026; ele veio depois de uma build de preview de abril de 2026 que muitas páginas de comparação mais antigas (incluindo algumas que ainda rankeiam) na verdade estão medindo em seu lugar. Segundo a ficha de modelo da NIM da NVIDIA, é um modelo de mixture-of-experts com 1,6 trilhão de parâmetros totais e 49 bilhões ativos por token, 384 especialistas roteados com 6 selecionados por token, uma janela de contexto de 1 milhão de tokens, e uma saída máxima de 384.000 tokens. Uma fonte secundária lista a ficha de disponibilidade geral em 1,7 trilhão no total em vez de 1,6 trilhão; não conseguimos confirmar essa discrepância contra o próprio relatório técnico da DeepSeek, e sinalizamos isso aqui em vez de escolher um número para parecer mais preciso do que as evidências sustentam.
Qwen3.8-Max-0902 é o flagship atual da Alibaba, uma atualização de setembro de 2026 da linha Qwen3.8-Max que foi lançada originalmente em 3 de agosto de 2026. É um modelo esparso de mixture-of-experts reportado com 2,4 trilhões de parâmetros totais e aproximadamente 95 bilhões ativos por token (512 especialistas, 10 selecionados por token, segundo múltiplos rastreadores independentes; as próprias páginas da Alibaba não publicam a contagem de especialistas diretamente). A Artificial Analysis lista sua janela de contexto em 984.000 tokens, essencialmente na mesma classe prática de 1M de tokens da DeepSeek, estendida a partir de uma janela nativa menor. Diferente da DeepSeek, o Qwen3.8 Max também aceita entrada de imagem pela API hospedada; o DeepSeek V4 Pro é apenas texto.
Preços: números oficiais, não suposições de agregador
A DeepSeek publica preços diretamente na própria documentação da sua API, divididos conforme você acessa em horário fora de pico ou de pico UTC. A Alibaba publica os preços do Qwen3.8-Max na própria página de preços do Model Studio, em CNY, em camadas por região de implantação: o preço da China/padrão global é notavelmente mais barato do que a implantação internacional de Singapura/EUA que a maioria dos desenvolvedores fora da China de fato vai usar.
Per 1M tokens              DeepSeek V4 Pro-0813      Qwen3.8 Max-0902
-----------------------------------------------------------------------
Input (peak hours)          $1.32                      $2.00
Input (off-peak, DeepSeek   $0.66                      n/a (flat rate)
  only, see note below)
Output (peak hours)         $3.96                      $6.00
Output (off-peak)           $1.98                      n/a
Cache hit                   $0.044                     $0.25
Blended (AA's 7:2:1 ratio)  $0.69                       $1.18

DeepSeek peak window (full price): 01:00-04:00 and 06:00-10:00 UTC,
Monday through Friday, excluding Chinese public holidays. Every other
hour, including weekends, bills at the cheaper off-peak rate. Source:
DeepSeek's own API docs, api-docs.deepseek.com/quick_start/pricing.
Qwen figures are the Singapore/US international deployment tier, converted
from Alibaba's own CNY 14.988 / CNY 44.965 per-million rate (Alibaba's
China/global-default tier is roughly 20% cheaper at CNY 12 / CNY 36).
Source: help.aliyun.com/en/model-studio/model-pricing, checked 14 Oct 2026.
Também existe uma camada econômica em cada lado que vale conhecer se o preço do flagship for mais do que você precisa: o deepseek-flash da DeepSeek (DeepSeek-V4.1-Flash) custa $0,15/$0,6 em horário de pico e $0,075/$0,3 fora de pico por milhão de tokens de entrada/saída, aproximadamente um nono do custo do flagship, com a mesma janela de contexto de 1M. O alias legado qwen-max da Alibaba tem preço igualmente reduzido na sua camada China/padrão global, a CNY 2,4/9,6 por milhão de tokens, um quinto do próprio CNY 12/36 do Qwen3.8 Max na camada da China, mas é um modelo apenas sem raciocínio, sem preços escalonados por tamanho de contexto, uma string de modelo fácil de pegar por engano se você estiver copiando um guia de integração antigo.
Benchmarks: onde cada um de fato vence
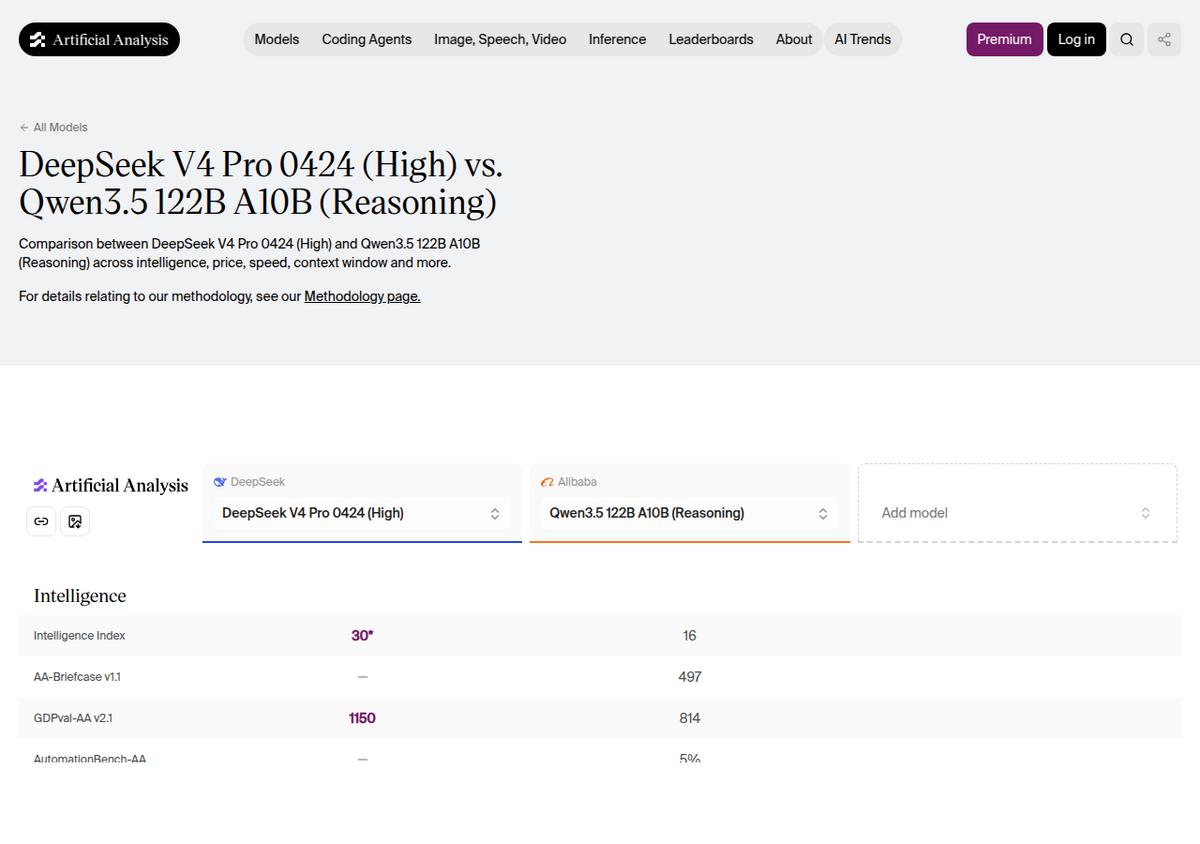
A Artificial Analysis roda um comparativo direto entre os flagships atuais, ambos configurados no esforço máximo de raciocínio, pontuados no seu Intelligence Index v4.3.2. O Qwen3.8 Max lidera em inteligência geral e na maioria das tarefas de trabalho agêntico de conhecimento; o DeepSeek V4 Pro está próximo ou na frente em benchmarks relacionados a codificação, e dramaticamente mais barato e mais rápido em tudo.
Benchmark (max effort)                 Qwen3.8 Max-0902    DeepSeek V4 Pro-0813
---------------------------------------------------------------------------
Intelligence Index (v4.3.2)             45                   36
Terminal-Bench 4.0 (agentic terminal)   39%                  14%
SciCode (coding)                        52%                  51%
AA-Briefcase v1.1 (agentic knowledge)   1617                 1257
GDPval-AA v2.1 (agentic real work)      1667                 1449
AutomationBench-AA (agentic SaaS)       56%                  57%
Humanity's Last Exam                    43%                  41%
GDP.pdf                                 23%                  11%
CritPt (physics reasoning)              18%                  18%
AA-Omniscience                          12                   1
AA-LCR v1.1 (long-context reasoning)    80%                  80%
Output speed (tokens/sec)               42                   99

Source: artificialanalysis.ai/models/comparisons/deepseek-v4-pro-vs-qwen3-8-max,
checked 14 Oct 2026. Note: Artificial Analysis publishes several versions of
this comparison at different DeepSeek reasoning-effort settings (High vs.
Max); scores shift by several points between them, so if you see different
numbers elsewhere, check which effort setting the page is showing.
O padrão que se mantém nas duas tabelas: a Qwen vence em tarefas que recompensam conhecimento amplo e planejamento agêntico em várias etapas (Terminal-Bench, AA-Briefcase, GDPval-AA, AA-Omniscience), enquanto as duas ficam essencialmente empatadas em codificação pura (SciCode) e recuperação de contexto longo (AA-LCR, ambas em 80%). Nenhum dos dois modelos publica um benchmark específico de matemática nesta comparação. Se sua carga de trabalho está mais perto de "escrever e depurar código" do que de "planejar e executar uma tarefa agêntica de várias etapas", a diferença de benchmark importa muito menos do que a diferença de preço de 70%.
Licenciamento: a lacuna que a maioria das comparações erra
Os pesos do DeepSeek V4 Pro são reportados como licenciados sob MIT, consistente com os lançamentos anteriores V3 e R1 da DeepSeek, segundo sua ficha na NVIDIA NIM e rastreadores de modelos independentes (não conseguimos extrair o arquivo de licença diretamente do próprio repositório da DeepSeek no Hugging Face para confirmar o texto exato, então trate isso como fortemente sourced, mas não verificado em fonte primária). A MIT é praticamente a licença mais permissiva que existe: uso comercial, modificação e redistribuição sem teto de receita.
O Qwen3.8 Max é uma história diferente, e é onde boa parte da cobertura "a Qwen é open source" exagera. O modelo da API hospedada é proprietário, ponto final, igual ao Gemini ou ao GPT. A Alibaba publicou separadamente um checkpoint de peso aberto por trás dele, reportadamente chamado Qwen3.8-2.4T-A95B, no Hugging Face por volta de 12 de agosto de 2026, apenas texto e travado em modo de raciocínio (a entrada de visão e o modo sem raciocínio que a API hospedada oferece não estão no lançamento aberto). Mas esse checkpoint é distribuído sob uma "licença Qwen3.8-Max" customizada, não Apache 2.0, e múltiplos rastreadores reportam que ela inclui uma ressalva de uso comercial exigindo um acordo separado quando a receita dos últimos 12 meses de uma empresa implantadora excede US$ 50 milhões em certas categorias de serviços de IA. Isso é um acordo materialmente diferente do modelo denso menor Qwen3.8-27B da Qwen, que é Apache 2.0, sem limite de receita. Não conseguimos extrair o texto exato da licença para citar seus termos literalmente, então verifique o arquivo de licença atual no Hugging Face diretamente antes de construir uma dependência de produção sobre ele. A conclusão prática: "a Qwen é de peso aberto" é verdade para os modelos menores da Qwen e falso, ou pelo menos fortemente qualificado, para seu flagship real de 2,4 trilhões de parâmetros.
Onde você de fato pode rodá-los
- As duas fornecedoras oferecem acesso direto via API: api.deepseek.com (endpoints compatíveis com OpenAI e Anthropic) e o Alibaba Cloud Model Studio para a Qwen, cobrados como mostrado acima.
- A AWS adicionou o DeepSeek-V3.1 e vários modelos Qwen3 ao Bedrock como ofertas totalmente gerenciadas em 2025 (segundo o próprio anúncio da Amazon): DeepSeek-V3.1 e Qwen3-Coder-480B em US East (Ohio) e AP (Jacarta), com Qwen3-32B, Qwen3-235B e Qwen3-Coder-30B também chegando à UE (Frankfurt). Verifique o catálogo atual do Bedrock para saber se o V4 Pro e o Qwen3.8 Max especificamente já chegaram lá, já que as adições ao Bedrock ficam atrás dos lançamentos novos.
- A licença MIT do DeepSeek V4 Pro torna a auto-hospedagem simples juridicamente, embora exija infraestrutura real. A geração anterior V3/R1 da DeepSeek, construída sobre uma arquitetura semelhante, precisa de aproximadamente 16 GPUs H100 para rodar na sua precisão nativa FP8, segundo a própria documentação de implantação da NVIDIA; configurações com 8 GPUs só são possíveis com quantização que custa alguma precisão. A pegada do V4 Pro está na mesma faixa. O checkpoint aberto da Qwen também pode ser auto-hospedado, sujeito aos termos de licença com limite de receita mencionados acima.
- A infraestrutura primária da DeepSeek e da Alibaba é baseada na China, embora ambas ofereçam endpoints de API internacionais (o api.deepseek.com padrão da DeepSeek, as implantações do Model Studio em Singapura/EUA da Alibaba). A própria página de preços da Alibaba lista uma camada dedicada e mais cara de "implantação nos EUA", o que sugere roteamento regional real em vez de um único endpoint global. Se residência de dados ou latência adicional até infraestrutura baseada na China for uma preocupação de conformidade para sua organização, verifique isso diretamente com qualquer uma das fornecedoras em vez de assumir um padrão.
Qual você deveria realmente escolher
Se custo por token e throughput bruto importam mais, ou sua carga de trabalho se inclina para codificação, o DeepSeek V4 Pro é a escolha clara: mais barato em todas as camadas, mais de duas vezes mais rápido, licenciado sob MIT se você algum dia quiser auto-hospedar, e competitivo no SciCode. Como a taxa com desconto da DeepSeek já se aplica por padrão fora de dois blocos estreitos de dias úteis, uma carga de trabalho em lote (processamento de documentos, pipelines noturnos) só precisa evitar esses horários específicos para rodar pela metade do preço. Especificamente para nosso público, essa vantagem de preço por token importa mais em fluxos de pesquisa de documentos longos e alto volume, passando um grande lote de artigos ou transcrições por um modelo de 1M de contexto, onde o prêmio de 70% da Qwen se acumula rápido ao longo de milhares de chamadas.
Se você precisa da pontuação mais alta em benchmarks amplos de trabalho agêntico e de conhecimento, quer entrada de imagem nativa no mesmo modelo, e a diferença de licenciamento não te afeta porque você está chamando a API hospedada de qualquer forma, o Qwen3.8 Max está na frente nos números que importam para tarefas complexas de várias etapas (Terminal-Bench, AA-Briefcase, GDPval-AA). A diferença é real, mas não é de graça: você paga aproximadamente 70% mais e recebe saída a menos da metade da velocidade por isso.
O que costuma confundir as pessoas
- O antigo alias qwen-max ainda resolve, custa um quinto do preço do flagship, e silenciosamente roda um modelo mais fraco, apenas sem raciocínio, sem preços escalonados. Se você copiou um trecho de integração de um guia mais antigo, verifique a string exata do modelo antes de assumir que está pagando as taxas do flagship.
- Um número surpreendente de páginas de comparação ainda rankeadas compara o DeepSeek-V4-Pro-0424, o preview de abril, contra o Qwen3.8 Max, o flagship atual, o que distorce a comparação a favor da Qwen tanto em preço quanto em pontuação de inteligência, já que a build de preview nunca foi o produto entregue. Verifique se qualquer comparação que você está lendo usa o lançamento de disponibilidade geral 0813 de agosto.
- O mesmo par de modelos pontua de forma diferente nas páginas de esforço "High" vs. "Max" da Artificial Analysis. Sempre verifique qual versão da comparação você está vendo antes de citar um número específico.
- O checkpoint de peso aberto do Qwen3.8 Max não corresponde à API hospedada: sem entrada de visão, sem modo sem raciocínio, e uma licença diferente dos modelos menores Apache 2.0 da Qwen.
As pessoas também perguntam
A DeepSeek ou a Qwen é melhor para codificação?
Elas estão próximas em codificação pura (SciCode: DeepSeek 51% vs. Qwen 52%), mas o DeepSeek V4 Pro fica bem atrás em uso agêntico de terminal (Terminal-Bench 4.0: 14% vs. 39% da Qwen). Para geração direta de código, ambos funcionam; para tarefas de codificação agêntica que envolvem planejar e executar ações de terminal em várias etapas, o Qwen3.8 Max atualmente pontua muito mais alto.
A DeepSeek é mais barata do que a Qwen?
Sim, em todas as camadas verificadas. A taxa de horário de pico do DeepSeek V4 Pro é $1,32/$3,96 por milhão de tokens de entrada/saída contra os $2,00/$6,00 fixos da Qwen3.8 Max, e a DeepSeek cai para $0,66/$1,98 fora de pico, que é o padrão na maior parte da semana, exceto dois blocos estreitos de dias úteis em horário UTC. O preço da Qwen nunca muda conforme o horário do dia.
O DeepSeek V4 Pro é open source?
Seus pesos são reportados como licenciados sob MIT, a licença padrão da DeepSeek para lançamentos anteriores como o V3 e o R1, que permite uso comercial e auto-hospedagem sem restrição de receita. Não conseguimos verificar de forma independente o arquivo de licença exato a partir do próprio repositório da DeepSeek, então verifique isso diretamente antes de depender dele para uma implantação de produção.
O Qwen3.8 Max é de peso aberto?
Parcialmente, e com ressalvas que boa parte da cobertura deixa passar. O modelo da API hospedada é proprietário. A Alibaba publicou separadamente um checkpoint de peso aberto por trás dele em agosto de 2026, mas sob uma "licença Qwen3.8-Max" customizada, não a licença permissiva Apache 2.0 usada pelos modelos menores da Qwen, reportadamente incluindo um limite de receita comercial para implantações de grande escala.
Qual tem a janela de contexto mais longa, a DeepSeek ou a Qwen?
Estão essencialmente empatadas: o DeepSeek V4 Pro lista uma janela de contexto de 1.000.000 de tokens, o Qwen3.8 Max lista 984.000, ambos segundo a comparação atual da Artificial Analysis. As duas são estendidas a partir de janelas nativas menores, não nativamente desse tamanho.
Posso auto-hospedar a DeepSeek ou a Qwen em vez de usar a API?
Ambas são tecnicamente possíveis. A licença MIT do DeepSeek V4 Pro torna a auto-hospedagem simples juridicamente, embora o modelo de 1,6 trilhão de parâmetros precise de infraestrutura multi-GPU séria. O checkpoint de peso aberto da Qwen também pode ser auto-hospedado, mas o limite de receita comercial da sua licença customizada vale ser verificado contra a escala da sua organização antes de se comprometer.