O Mistral Large 4 foi lançado em preview público em 6 de outubro de 2026, um modelo Mixture-of-Experts com 52 bilhões de parâmetros ativos, um número que o próprio blog da Mistral e a documentação técnica agora concordam entre si. A contagem total de parâmetros é onde os próprios materiais da Mistral ainda discordam: 1 trilhão segundo o blog, 1,05 trilhão segundo a documentação técnica, e um vago ">1 trilhão" no arquivamento legal da Mistral para o AI Act da UE. A cobertura de lançamento da VentureBeat citou separadamente 49 bilhões de parâmetros ativos, um número que não aparece em nenhum material atual da própria Mistral.
A janela de contexto tem uma lacuna parecida. A Mistral declara 1 milhão de tokens. Os rastreadores independentes Artificial Analysis e Vals.ai medem, na prática, algo mais próximo de 512.000-524.000 tokens, e até o próprio box de especificações e o FAQ da Artificial Analysis discordam entre si (524 mil vs. 520 mil).
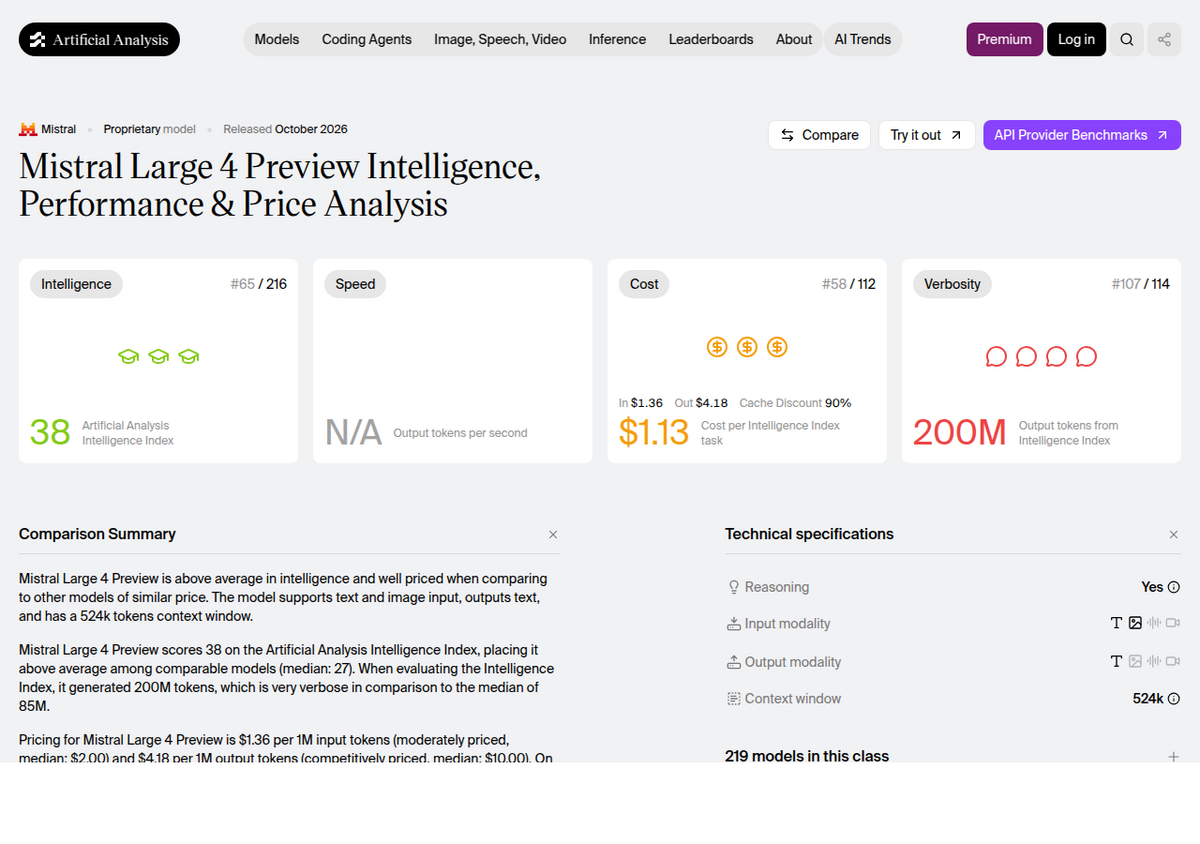
De forma independente, ele pontua de forma respeitável, mas não de ponta. A Artificial Analysis o coloca em 38 no seu Intelligence Index, na posição #65 de 216 modelos rastreados, acima da mediana da categoria, mas bem atrás do Claude Opus 5.5 (58) e de vários modelos chineses de peso aberto.
É apenas via API hoje, sem camada gratuita. Os pesos abertos foram prometidos para "o fim de outubro" segundo a Mistral, sem data confirmada; um desconto de lançamento por tempo limitado de 50% leva o preço a US$ 0,68/US$ 2,09 por milhão de tokens de entrada/saída até aproximadamente 20 de outubro.
O que o Mistral Large 4 realmente é
Mistral Large 4 é um modelo Mixture-of-Experts que a Mistral descreve como um "sistema híbrido de instrução e raciocínio de peso aberto" com entrada multimodal e saída apenas em texto: ele aceita texto e imagens (até 8 por requisição, segundo o próprio arquivamento de conformidade da Mistral para o AI Act da UE), mas só escreve texto de volta, sem geração de imagens. Ele inclui um codificador de visão separado, de 1,6 bilhão de parâmetros, para o lado de imagens, um detalhe confirmado na documentação técnica da Mistral, mas ausente do próprio post do blog da empresa e da maior parte da cobertura de imprensa. A API expõe um parâmetro reasoning_effort, consistente com o enquadramento de "raciocínio híbrido": é possível ajustar o quanto o modelo pensa antes de responder, trocando latência por qualidade.
A Mistral o treinou em aproximadamente 3.800 GPUs Nvidia Grace Blackwell (número da própria Mistral; a cobertura de imprensa arredonda para "cerca de 4.000") ao longo de cerca de dois meses, cobrindo mais de 160 idiomas, incluindo todos os idiomas oficiais da UE. Pierre Stock, VP de Ciência da Mistral, disse à TechCrunch que a rodada de treinamento usou "duas a três vezes menos" computação do que concorrentes chineses não nomeados, uma alegação de eficiência que vale notar como vinda da própria empresa, não verificada de forma independente. Um detalhe que vale levar em conta antes de julgar o modelo com muita dureza em qualquer benchmark isolado: o próprio blog da Mistral afirma que o treinamento por reforço ainda estava "em andamento" no lançamento, o que significa que o checkpoint do preview público é explicitamente um modelo inacabado, não a versão final da Mistral.
O apelido "Le Chonk" tem uma origem específica e verificável: em junho de 2026, uma piada se espalhou online sobre um modelo fictício chamado "Le Chaton Fat", com benchmarks fabricados de 30 trilhões de parâmetros. O CEO da Mistral, Arthur Mensch, entrou na brincadeira nas redes sociais na época, e quando o Mistral Large 4 de fato chegou como um modelo genuinamente descomunal meses depois, o apelido interno pegou, com Mensch supostamente brincando que o modelo é "actually le gros chaton". É um detalhe pequeno, mas é o tipo de coisa que mostra que a Mistral está consciente, e confortável, com seu próprio posicionamento de "modelo grande" dessa vez.
A contagem total de parâmetros depende de qual página da Mistral você lê
Source                                Total params      Active params
---------------------------------------------------------------------------
Mistral's launch blog post             1 trillion         52 billion
docs.mistral.ai model page              1.05 trillion       52 billion
VentureBeat (launch-day reporting)      1 trillion          49 billion
EU AI Act technical documentation       ">1 trillion"       not disclosed
  (legal filing)

Mistral's blog and technical docs now agree on 52 billion active
parameters. The total count still varies across Mistral's own materials,
and VentureBeat's widely-repeated 49 billion figure doesn't appear in any
current Mistral-published page we could find.
Esse arquivamento legal vale um segundo olhar por um motivo diferente. A documentação técnica da Mistral para o AI Act da UE, destinada a provedores downstream, a divulgação de conformidade exigida para operar na UE, lista a entrada e saída máxima de texto do modelo como um simples "250 tokens". Esse número é quase certamente um campo de modelo que a Mistral nunca preencheu corretamente, e não um limite real (todas as outras fontes, incluindo a própria documentação da Mistral, declaram uma janela de contexto na faixa de centenas de milhares até um milhão de tokens), mas é uma excentricidade genuína e verificável na própria papelada oficial da Mistral: renderizamos o arquivamento diretamente, em vez de depender de uma extração automática de texto, e o número aparece impresso exatamente assim. Não cite 250 tokens como uma restrição real; trate isso como um sinal de que a documentação de conformidade da Mistral para este lançamento foi apressada.
Janela de contexto: 1 milhão de tokens alegados, cerca da metade disso medido
A própria documentação da Mistral declara uma janela de contexto de 1.000.000 de tokens, o número repetido na maior parte da cobertura de lançamento. Os rastreadores independentes de API medem algo menor na prática: a Vals.ai lista uma janela de contexto de 512.000 tokens com uma saída máxima de 256.000 tokens, e o box de especificações da Artificial Analysis discorda da própria página de FAQ, 524.000 contra 520.000 tokens. Nenhum desses três números independentes corresponde à alegação de 1 milhão da Mistral, e os dois rastreadores independentes nem concordam precisamente entre si. Se um fluxo de trabalho depende de usar de fato a janela completa de um milhão de tokens, teste com seu próprio documento longo antes de construir em torno desse número; a diferença entre a capacidade alegada e a medida aqui é grande o suficiente para importar.
Preços, e um desconto que já está contando os dias
Tier                      Input ($/M tokens)   Output ($/M tokens)
---------------------------------------------------------------------
List price                 1.36                  4.18
Launch discount (50% off,   0.68                  2.09
  ~2 weeks from 6 Oct)
Cached input, discounted    0.07                  n/a

Mistral's own changelog states the discount runs roughly two weeks from
launch, putting the likely end date around 20 October 2026. No exact end
date is published on the pricing page itself, so confirm the live price
on Mistral's own console before relying on it.
Como ele se compara nos benchmarks, medido de forma independente
A Artificial Analysis, que roda todos os modelos pelo mesmo Intelligence Index padronizado em vez de usar a pontuação autorreportada por cada fornecedor, coloca o Mistral Large 4 em 38, na posição #65 de 216 modelos rastreados, contra uma mediana de categoria de aproximadamente 26-27. É um resultado genuinamente acima da média e um salto grande sobre o antigo carro-chefe da própria Mistral (mais sobre isso abaixo), mas não é um resultado de ponta: o Claude Opus 5.5 lidera a tabela com 58, o Claude Sonnet 5.5 fica em 51,9, e vários modelos chineses de peso aberto, o MiMo-V2.6-Pro (46), o GLM-5.3 (45) e o Qwen 3.8 Max (45,4), todos pontuam mais alto que o Mistral Large 4 no mesmo índice. O próprio enquadramento da Mistral, "o modelo mais forte fora dos EUA e da China", se sustenta contra concorrentes ocidentais fechados como o GPT-6 Luna (aproximadamente 37-38), mas não contra esses modelos chineses abertos, o que é uma alegação significativamente mais estreita do que a manchete sugere. Para efeito de escala, o outro grande lançamento da mesma semana, a camada acessível via API do Muse Wonder, da Meta, pontua 52 no mesmo índice independente, bem na frente do Mistral Large 4.
Dois números independentes importam mais que a pontuação de destaque se você está decidindo se vai de fato usar esse modelo. Primeiro, a taxa de alucinação: a medição AA-Omniscience da Artificial Analysis a coloca em 41,9%, apontada pela avaliadora independente eesel.ai como o maior ponto fraco deste lançamento, algo que vale saber antes de usá-lo para qualquer coisa em que uma resposta errada, mas confiante, saia caro. Segundo, o formato da latência: uma vez que começa a transmitir a resposta, a saída roda a uma razoável 116 tokens por segundo, mas o tempo até o primeiro token em prompts longos foi medido em cerca de 18,7 segundos, rápido depois que começa, lento para começar. Essa é uma combinação ruim para uma interface de chat em tempo real e uma boa para uma tarefa em lote que tolera um atraso de inicialização.
A Vals.ai, outra rastreadora independente com um conjunto de comparação diferente, mais inclinado a modelos de ponta mais fortes, o pontua mais baixo em termos relativos: 48,05% no Vals Index, #35 de 47. Seu melhor desempenho relativo é no Legal Agent Benchmark da Harvey, uma tarefa de documento jurídico em que fica em #9 de 79, uma colocação respeitável mesmo que a pontuação bruta (15,83%) pareça pouco impressionante isoladamente, já que benchmarks de raciocínio jurídico desse tipo pontuam baixo de forma geral. Seu desempenho mais fraco é no MysteryMechanism, onde termina em último lugar, #27 de 27. Em cibersegurança especificamente, os números autorreportados da própria Mistral (82-93% em tarefas de reprodução e correção de vulnerabilidades) precisam de uma ressalva que avaliadores da apidog apontaram diretamente: o Claude Opus 5.5 e o GPT-6 Astra pontuam perto de zero na mesma comparação autorreportada não porque não conseguem fazer a tarefa, mas porque a recusam por motivos de segurança. Essa é uma diferença de metodologia, não uma pura lacuna de capacidade, e os próprios materiais da Mistral não deixam essa distinção clara.
Mistral Large 4 vs. Mistral Large 3
                          Mistral Large 3        Mistral Large 4
------------------------------------------------------------------------
Total / active params      675B / 41B             ~1T-1.05T / 52B
Training hardware          3,000 Nvidia H200       3,800 Nvidia Blackwell
Released                    ~December 2025          6 October 2026
AA Intelligence Index       9                       38 (~4.2x higher)
Verbosity (output tokens     9.8M                    200M (~20x more
  to run full Index)                                  verbose)
Cost per Index task          $0.03                   $1.13 (~38x higher)

Intelligence Index, verbosity and cost figures are Artificial Analysis's
own independent measurements, not Mistral-reported.
O salto de capacidade do Large 3 para o Large 4 é real e substancial pela medida independente da Artificial Analysis, aproximadamente 4 vezes a pontuação do Intelligence Index. Ele vem com um custo alto: o modelo é cerca de 20 vezes mais verboso na mesma avaliação, e o preço para rodar uma única tarefa do Intelligence Index subiu de US$ 0,03 para US$ 1,13, cerca de 38 vezes mais caro. Se você está avaliando se vale a pena atualizar um fluxo de trabalho construído sobre o Large 3, planeje esse aumento de custo explicitamente, em vez de assumir que um modelo mais novo e mais inteligente é automaticamente mais barato de rodar por tarefa.
Pesos abertos: "fim de outubro", mas não confirmado
O próprio blog e changelog da Mistral descrevem os pesos abertos como algo a chegar "até o fim do mês" ou simplesmente "em breve", sem uma data específica. A cobertura da VentureBeat cita um alvo específico de 27 de outubro de 2026, enquadrado como o fim de um período de teste de cerca de três semanas com desenvolvedores, pesquisadores de cibersegurança e autoridades governamentais, mas essa data é uma inferência da própria VentureBeat a partir do enquadramento de "três semanas" da Mistral, não uma data que a própria Mistral publicou. A cobertura da TechCrunch é ainda mais vaga, citando "apenas três semanas" após o lançamento de 6 de outubro. Trate o fim de outubro como direcionalmente correto e 27 de outubro especificamente como não confirmado. A licença para o eventual lançamento aberto também não está finalizada: a VentureBeat relata que a Mistral espera usar uma licença Mistral personalizada, em vez de uma padrão como a Apache 2.0 ou a MIT, mas isso também ainda não foi publicado, e o acesso de hoje é regido apenas pelos termos de serviço e pelo acordo de autoimplantação da Mistral.
Como acessá-lo hoje
Agora, a única forma confirmada de usar o Mistral Large 4 é através da própria documentação de API da Mistral ou do console Mistral Studio, sob o ID de modelo mistral-large-4 (listado na página de documentação como mistral-large-4-0). A TechCrunch descreve especificamente o acesso atual como limitado a "um endpoint público com guardrails", algo a se ter em mente se você precisa de acesso irrestrito para uma carga de trabalho sensível. Ele também já está listado em gateways de terceiros, incluindo a OpenRouter (como mistralai/mistral-large-4-0), a Eden AI e a LLMGateway. Não conseguimos confirmar se ele já está disponível dentro do Vibe, o próprio app de chat para consumidores da Mistral (renomeado de Le Chat em maio de 2026, com contas e assinaturas mantidas); o anúncio da Mistral linka para o Vibe sem afirmar que o modelo está disponível lá, então verifique diretamente em chat.mistral.ai antes de assumir que é possível testá-lo ali de graça.
Vale a pena usar
- Hospedagem soberana na UE ou trabalho multilíngue entre idiomas oficiais da UE: um bom encaixe, e um dos diferenciais mais claros da Mistral contra laboratórios dos EUA e da China.
- Documentos jurídicos ou de conformidade longos: a classificação no Legal Agent Benchmark da Harvey (#9 de 79, medido de forma independente) sugere uma força real aqui, embora a pontuação bruta seja modesta em termos absolutos.
- Chat em tempo real ou aplicações sensíveis à latência: um encaixe mais fraco, dado o tempo até o primeiro token de cerca de 18,7 segundos em prompts longos, mesmo que a velocidade de saída, uma vez iniciada, seja boa.
- Qualquer coisa em que uma resposta errada, mas confiante, saia caro: a taxa de alucinação medida de forma independente, de 41,9%, é o ponto fraco mais citado entre os avaliadores; verifique as respostas em vez de confiar nelas de cara.
- Codificação de ponta ou trabalho agêntico sensível à latência: um encaixe mais fraco. Seu Intelligence Index da Artificial Analysis (38) fica atrás de vários modelos chineses de peso aberto (o MiMo-V2.6-Pro com 46, o GLM-5.3 com 45 e o Qwen 3.8 Max com 45,4), que também são de peso aberto, uma comparação que provavelmente importa mais para desenvolvedores escolhendo um modelo de codificação.
As pessoas também perguntam
O Mistral Large 4 é gratuito?
Não existe camada gratuita. É apenas via API, cobrado por token, com um desconto de lançamento por tempo limitado de 50% (aproximadamente US$ 0,68/US$ 2,09 por milhão de tokens de entrada/saída) que o próprio changelog da Mistral diz durar cerca de duas semanas a partir do lançamento em 6 de outubro de 2026.
O Mistral Large 4 é open source ou de peso aberto?
Ainda não. A Mistral o descreve como destinado a ser de peso aberto e promete os pesos "até o fim de outubro" de 2026, com a VentureBeat relatando um alvo específico, mas não confirmado, de 27 de outubro. A licença ainda não foi finalizada; a Mistral espera usar uma licença personalizada em vez de uma padrão como a Apache 2.0.
Quantos parâmetros o Mistral Large 4 tem?
52 bilhões de parâmetros ativos, um número que o próprio blog e a documentação técnica da Mistral agora concordam entre si. A contagem total de parâmetros ainda varia entre os materiais da própria Mistral: 1 trilhão segundo o blog de lançamento, 1,05 trilhão segundo a documentação técnica. A cobertura de lançamento da VentureBeat citou separadamente 49 bilhões de parâmetros ativos, um número não encontrado nas páginas atuais da própria Mistral.
Qual é a janela de contexto real do Mistral Large 4?
A Mistral declara 1 milhão de tokens. Os rastreadores independentes medem menos na prática: a Vals.ai lista 512.000 tokens, e o box de especificações da Artificial Analysis discorda da própria página de FAQ, com 524.000 contra 520.000 tokens.
Como o Mistral Large 4 se compara ao Mistral Large 3?
Cerca de 1,5 vez o total de parâmetros, em hardware Nvidia Blackwell mais novo. De forma independente, a Artificial Analysis mede um salto de aproximadamente 4x na pontuação do Intelligence Index (de 9 para 38), mas com uma verbosidade de saída cerca de 20 vezes maior e um custo de avaliação por tarefa subindo de US$ 0,03 para US$ 1,13, cerca de 38 vezes mais caro.
O Mistral Large 4 alucina muito?
A medição AA-Omniscience da Artificial Analysis coloca sua taxa de alucinação em 41,9%, apontada pela avaliadora independente eesel.ai como o maior ponto fraco do modelo. Verifique as respostas factuais em vez de confiar nelas de cara, especialmente para temas pouco conhecidos ou de nicho.
Em que o Mistral Large 4 é melhor?
Pontos fortes medidos de forma independente incluem trabalho jurídico e de documentos longos (uma classificação respeitável no Legal Agent Benchmark da Harvey) e tarefas de reprodução de vulnerabilidades de cibersegurança, embora as pontuações de cibersegurança autorreportadas pela Mistral precisem da ressalva de que alguns modelos rivais pontuam perto de zero no mesmo teste porque recusam a tarefa por motivos de segurança, não porque não conseguem realizá-la.